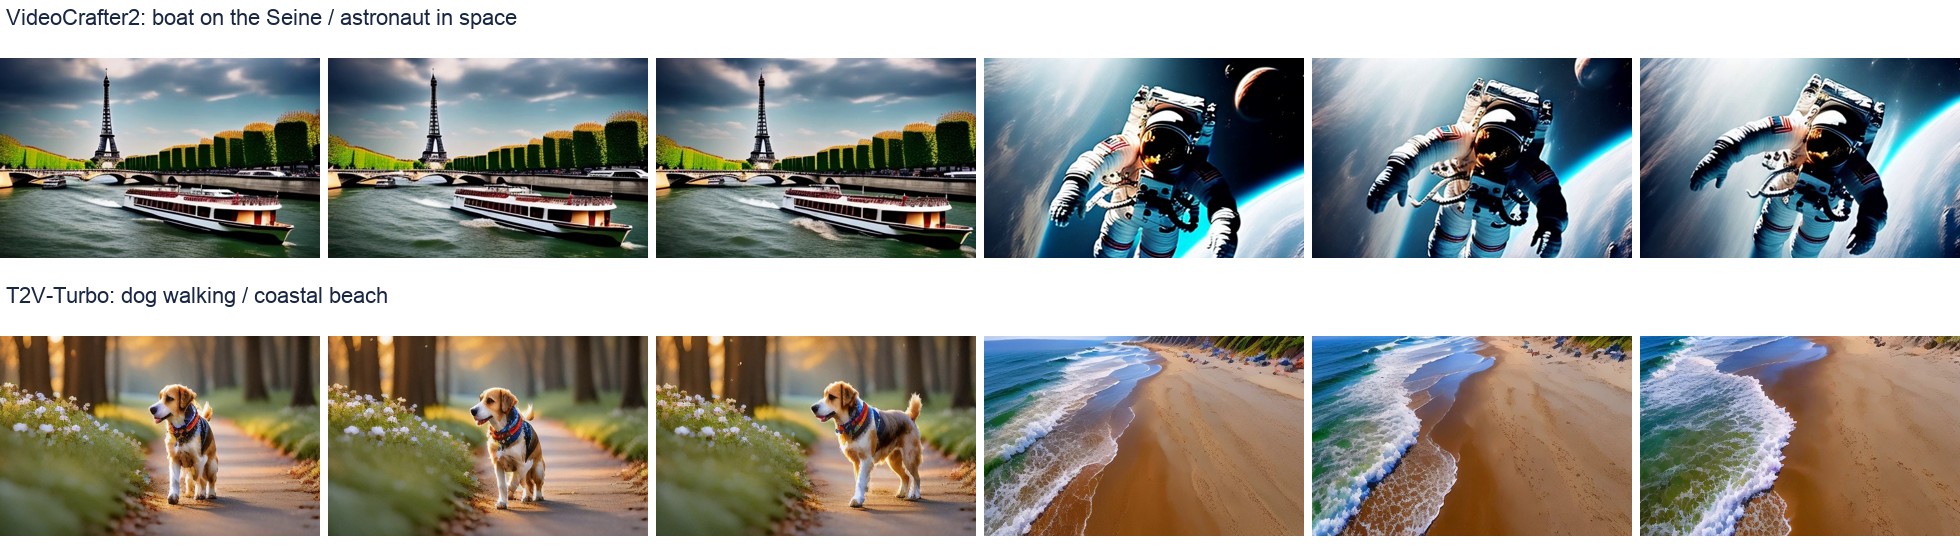
DDPO — Training Diffusion Models with Reinforcement Learning
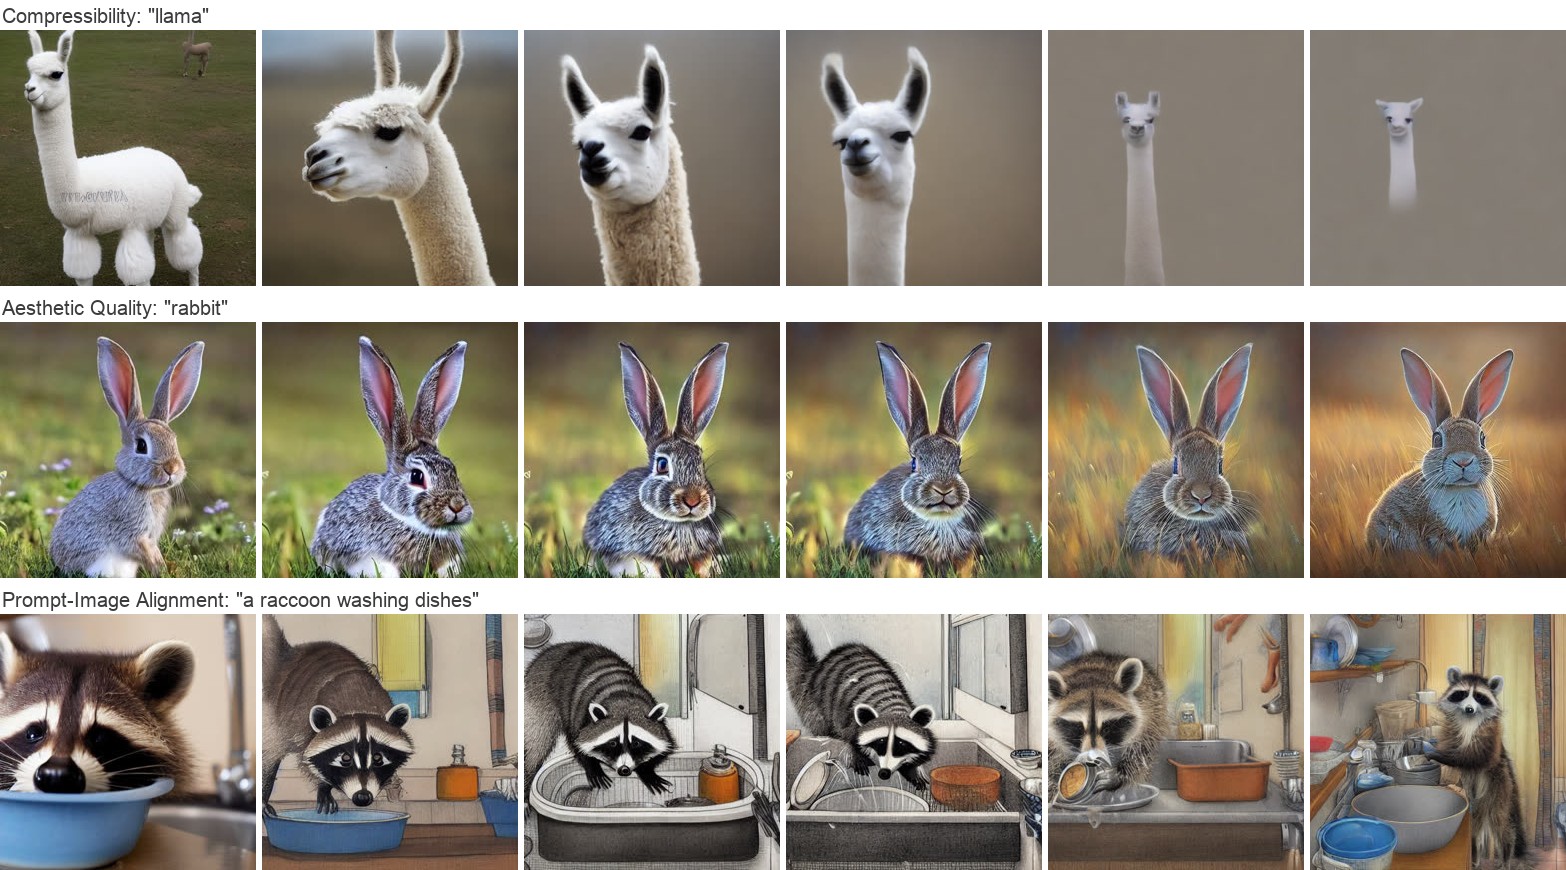
扩散模型是用「对数似然的近似」训出来的,但我们真正想要的往往不是似然,而是「图好不好看」「文件能不能压小」这类下游指标。这些指标没法写进 prompt,也没法用监督学习直接训。DDPO 的做法是:把 50 步去噪过程当成 50 步决策——每一步的「状态」是(prompt、当前时间步、当前噪声图),「动作」是这一步输出的更干净的图,「策略」就是去噪网络本身。因为采样器固定、每步加的高斯噪声方差已知,每一步的条件似然是可以精确算出来的,于是可以直接套用策略梯度(REINFORCE / PPO):采样一批轨迹 → 给最终图打一个奖励分 → 把奖励乘到「每步 log 概率的梯度」上,好图加分、差图减分…
VideoDPO — Omni-Preference Alignment for Video Diffusion Generation
把视频生成模型当成学生:给同一道题(提示词),让它用不同随机种子交四份答案(视频)。自动阅卷系统 OmniScore 同时看画面质量、帧间运动与文本匹配,选出最高分和最低分的视频。训练时不再重新生成整段视频,而是给保存的视频 latent 加噪,让可训练模型和冻结的参考模型分别预测噪声,用“赢家与输家的去噪误差差,相对于参考模型改善了多少”构建偏好损失。
MiniMax-H3 — A General-Purpose Omni-Modal Video Generation Model
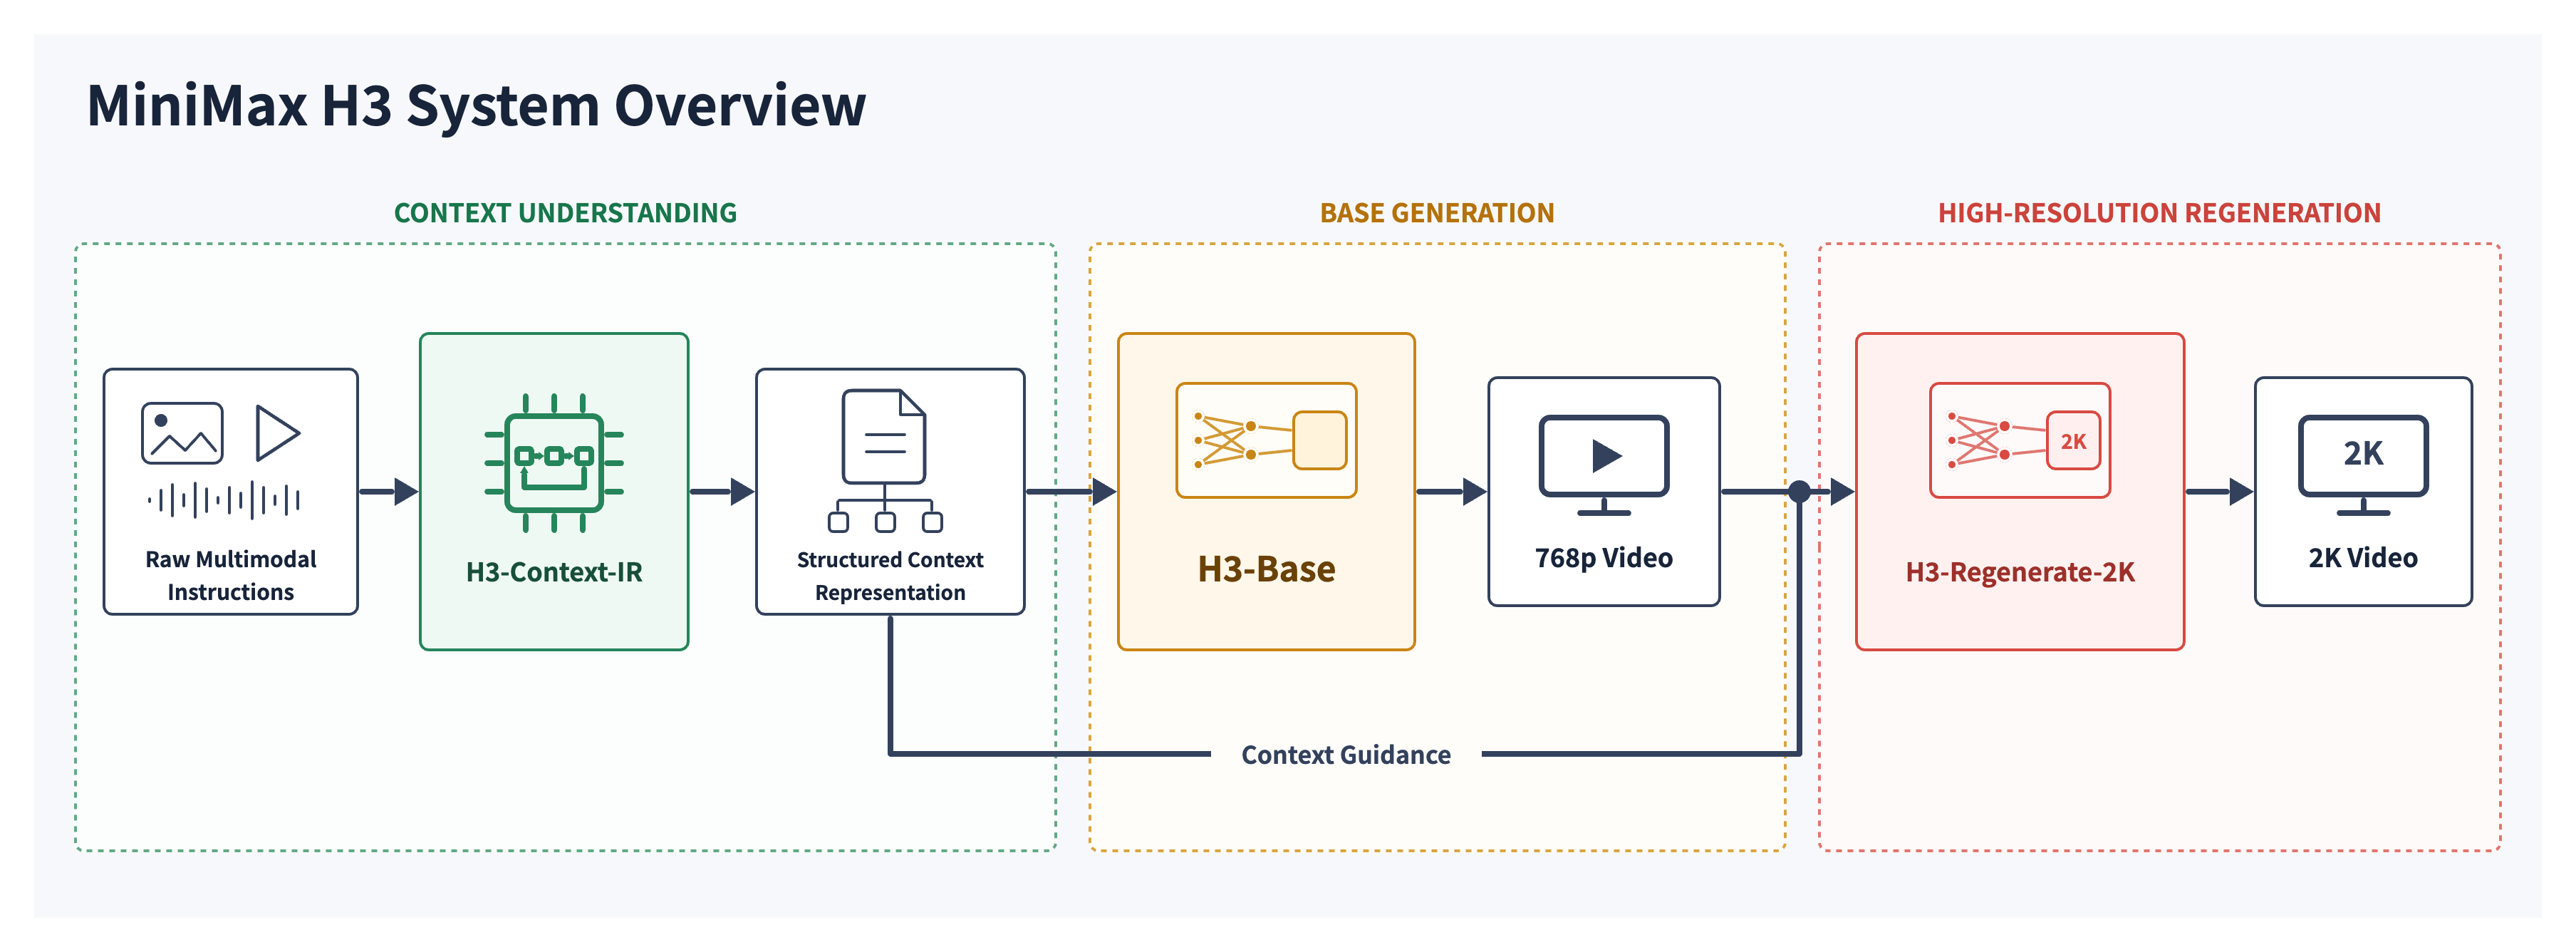
把 MiniMax-H3 想象成一个「全能导演」:你随手丢给它文字、几张图、几段参考视频和几段音频,它先派一个「编剧助理」(H3-Context-IR)把这堆杂乱素材读懂、理顺时序与关系,写成一份结构化的分镜脚本(Context 中间表示);然后「导演本体」(H3-Base,330 亿参数的单流 Transformer)照着脚本一次性把画面和立体声一起拍出来——注意是画面和声音联合生成,而不是先出画面再配音;最后如果你要更高清,它不另请「放大专家」,而是把 768p 成片连同原始素材塞回自己脑子里重画一遍成 2K(H3-Regenerate-2K)。
InnoAds-Composer — Efficient Condition Composition for E-Commerce Poster Generation
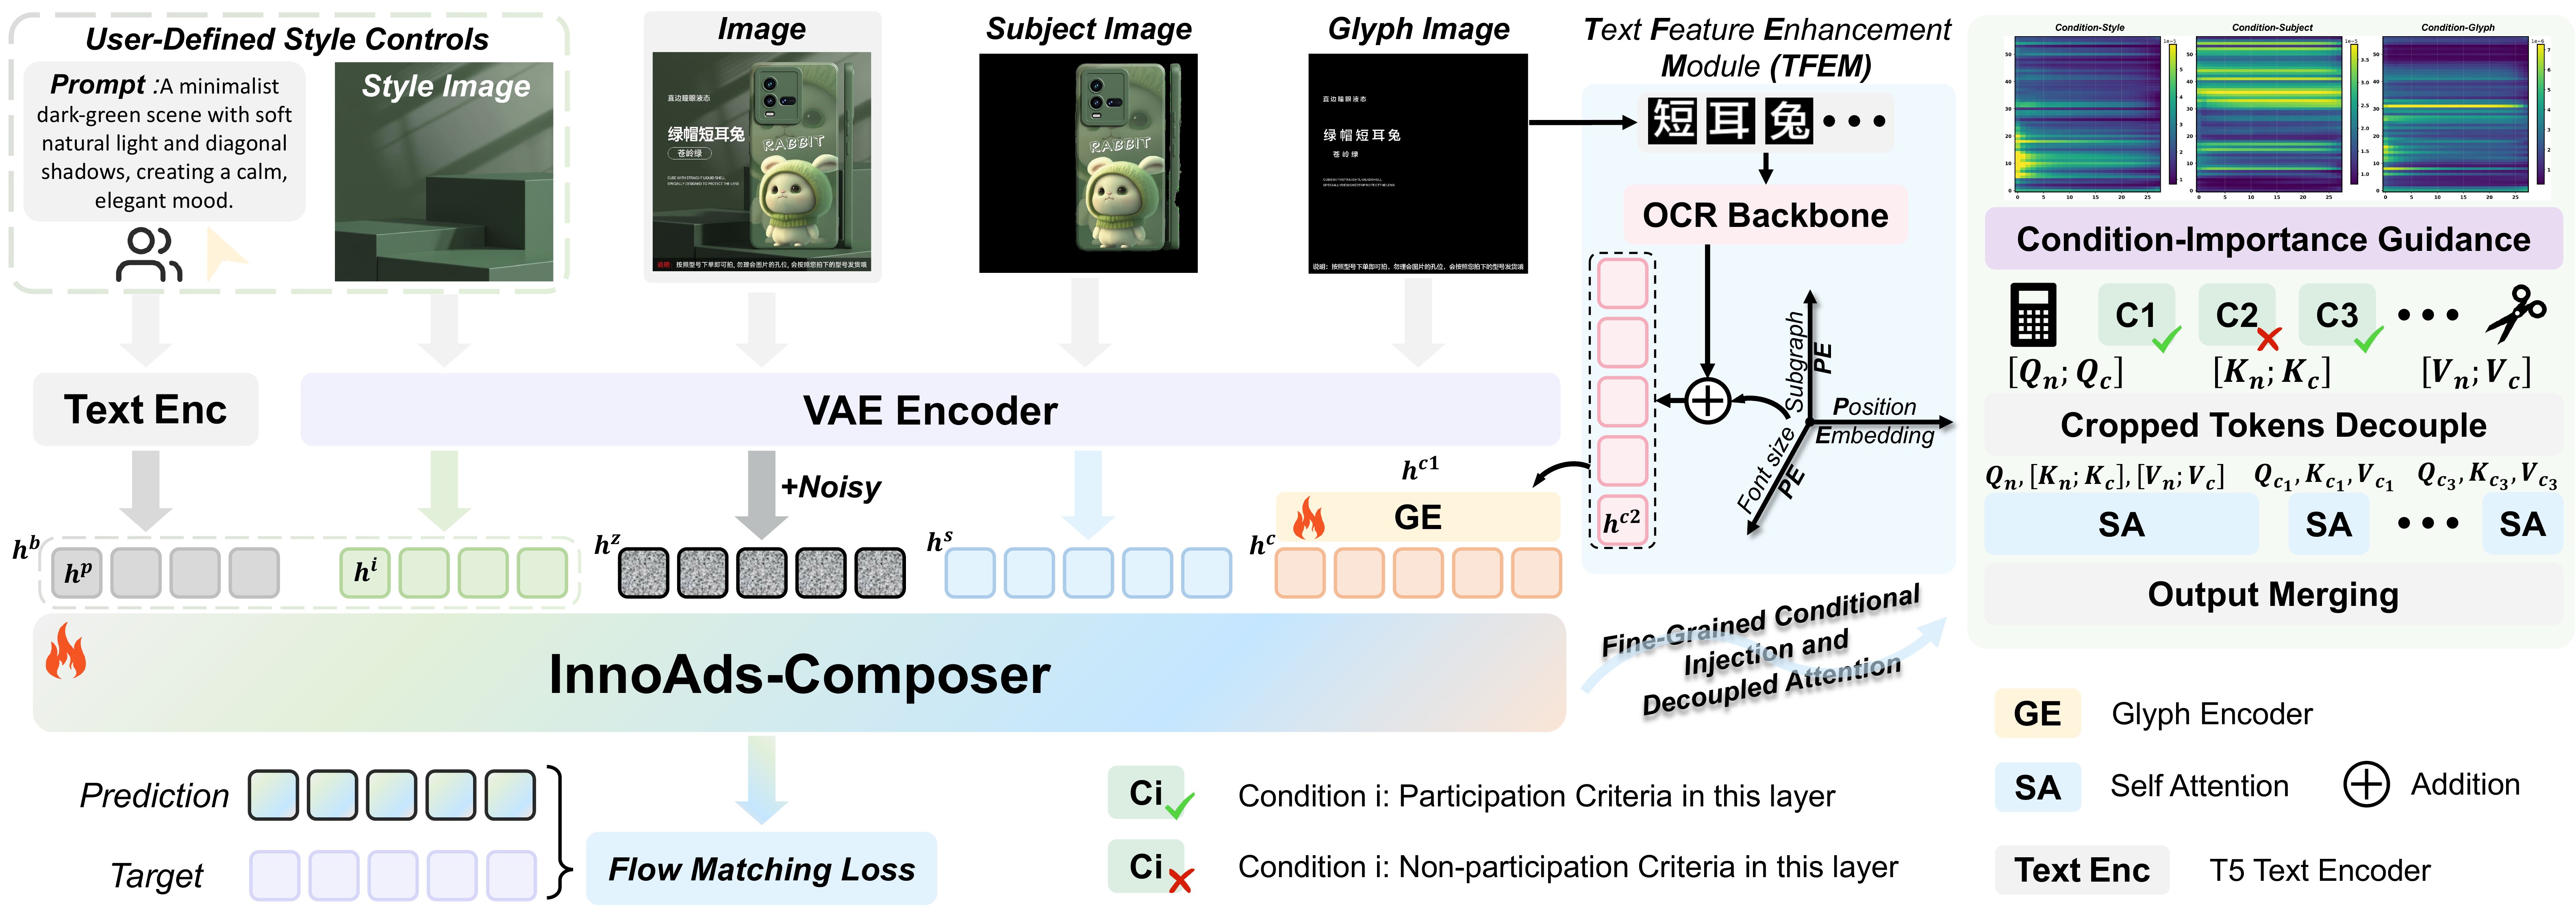
任务:电商海报 = 一张图里同时摆对商品主体、促销文案、背景风格。多阶段 pipeline(先合成场景再贴字)常出现主体走样、文字错字、风格不统一。
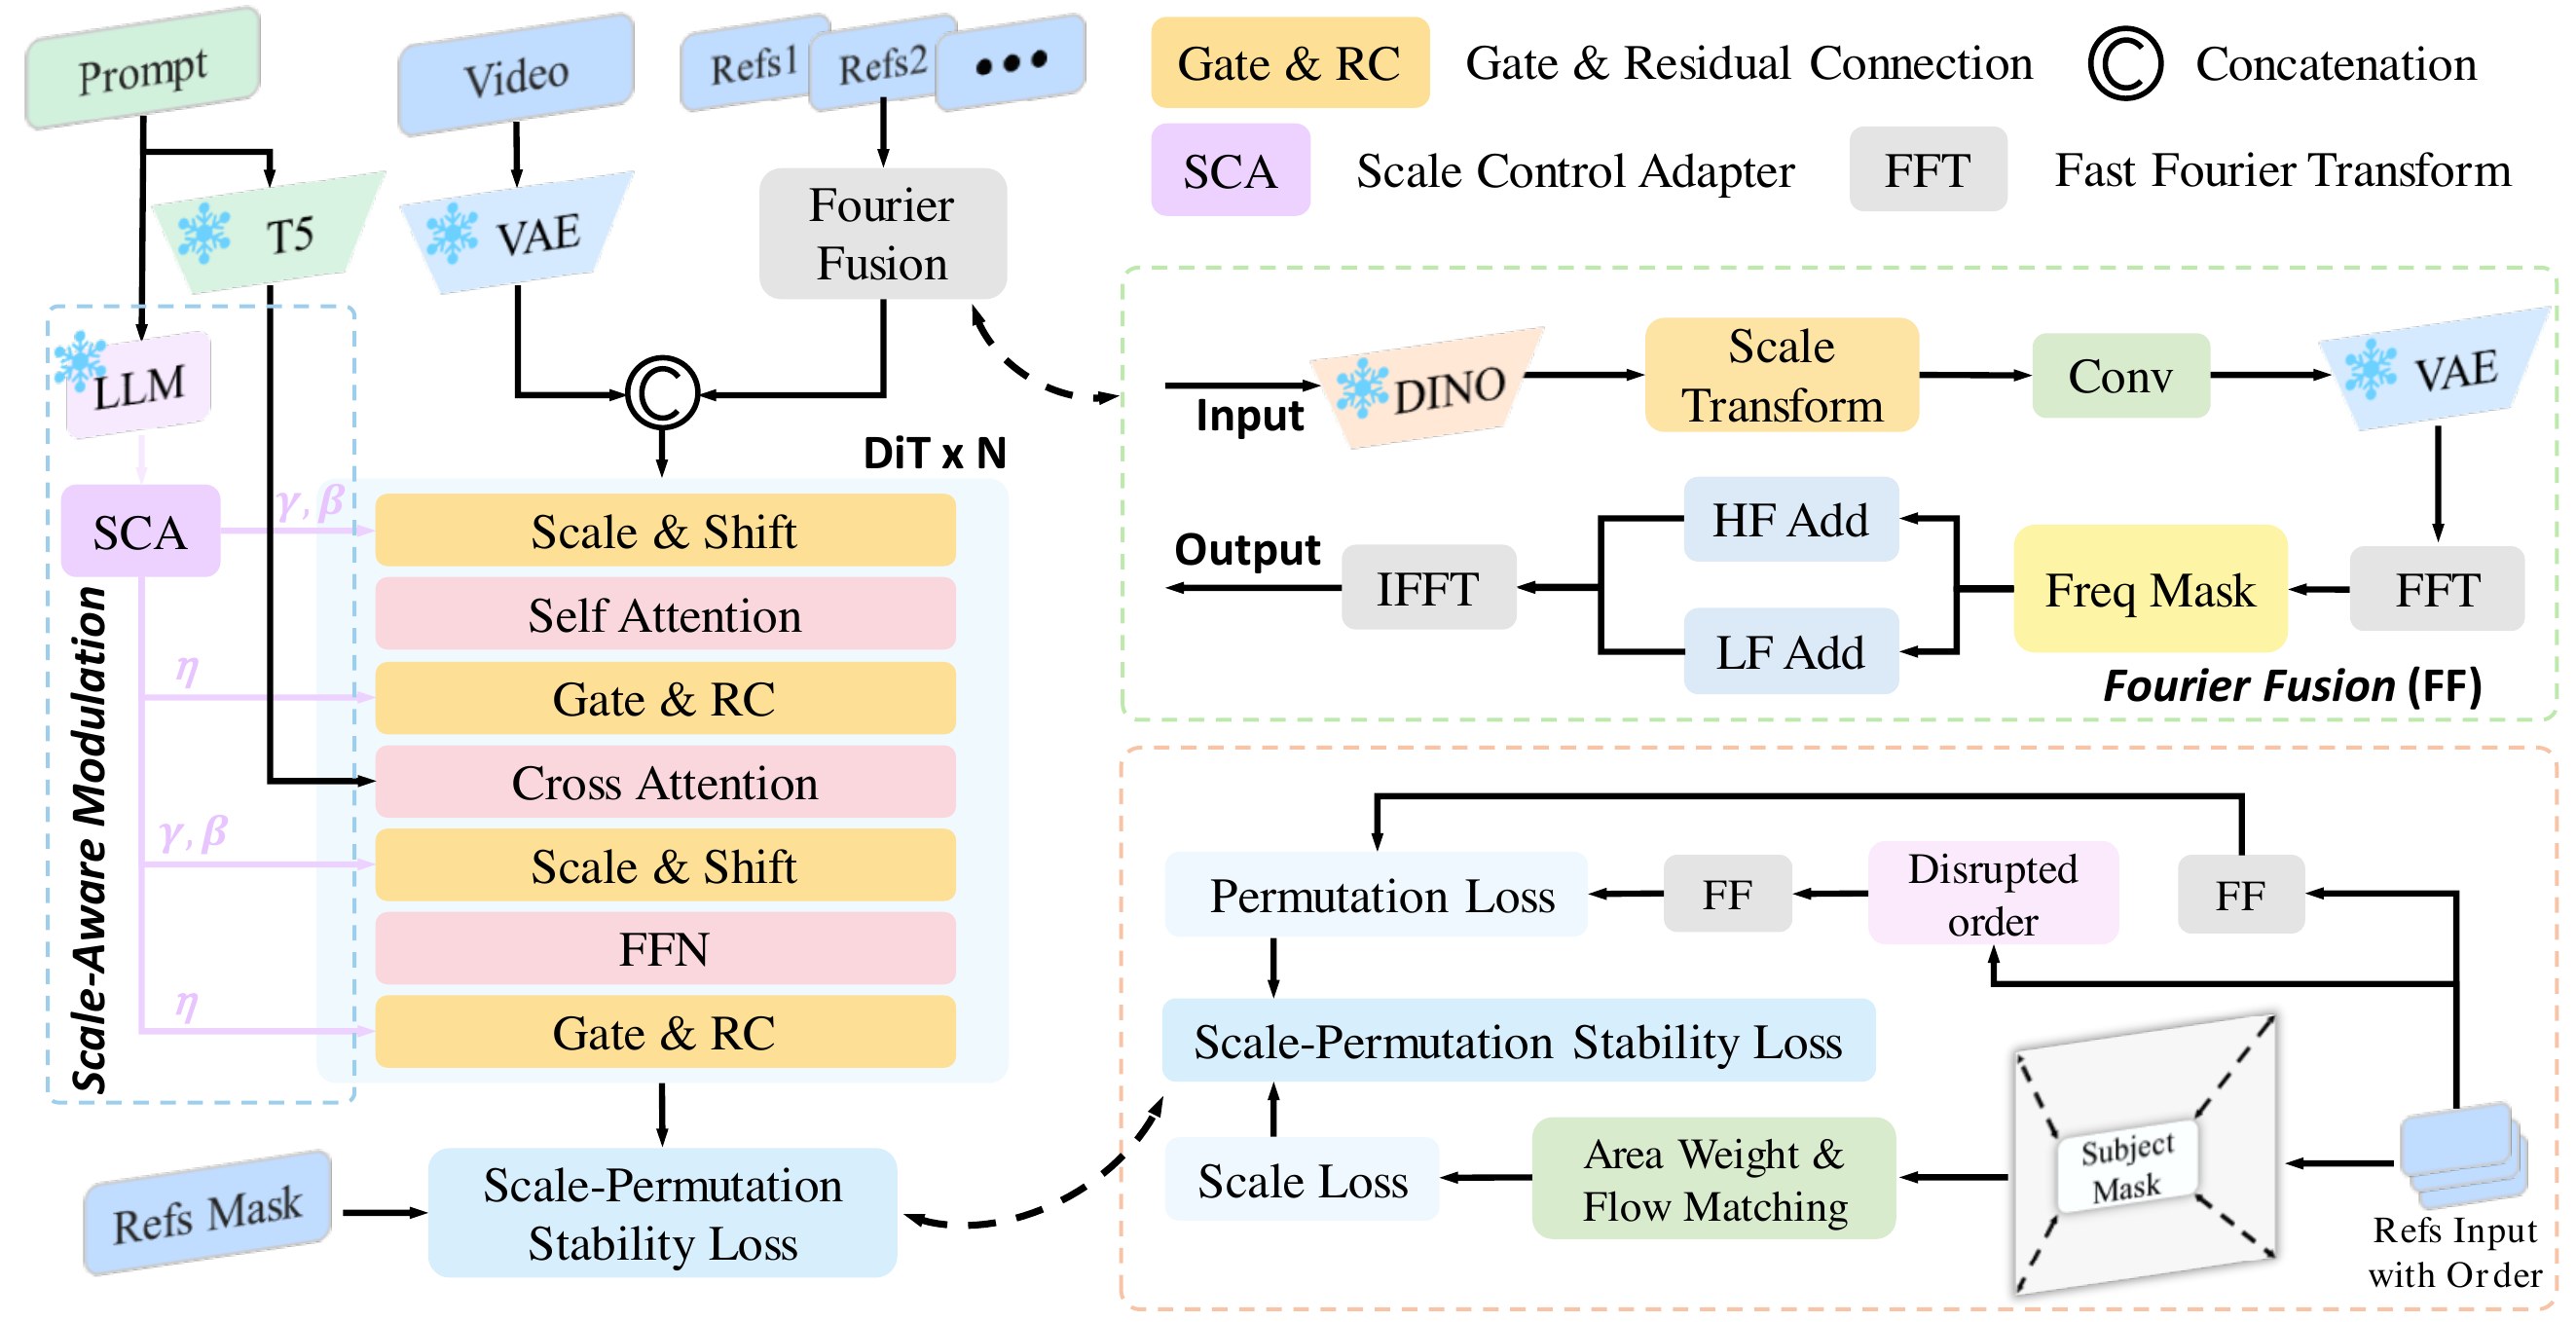
MoFu — Scale-Aware Modulation and Fourier Fusion for Multi-Subject Video Generation
任务:多主体视频生成——给定文本 + 多张参考图,生成多主体一致、尺度自然的视频。
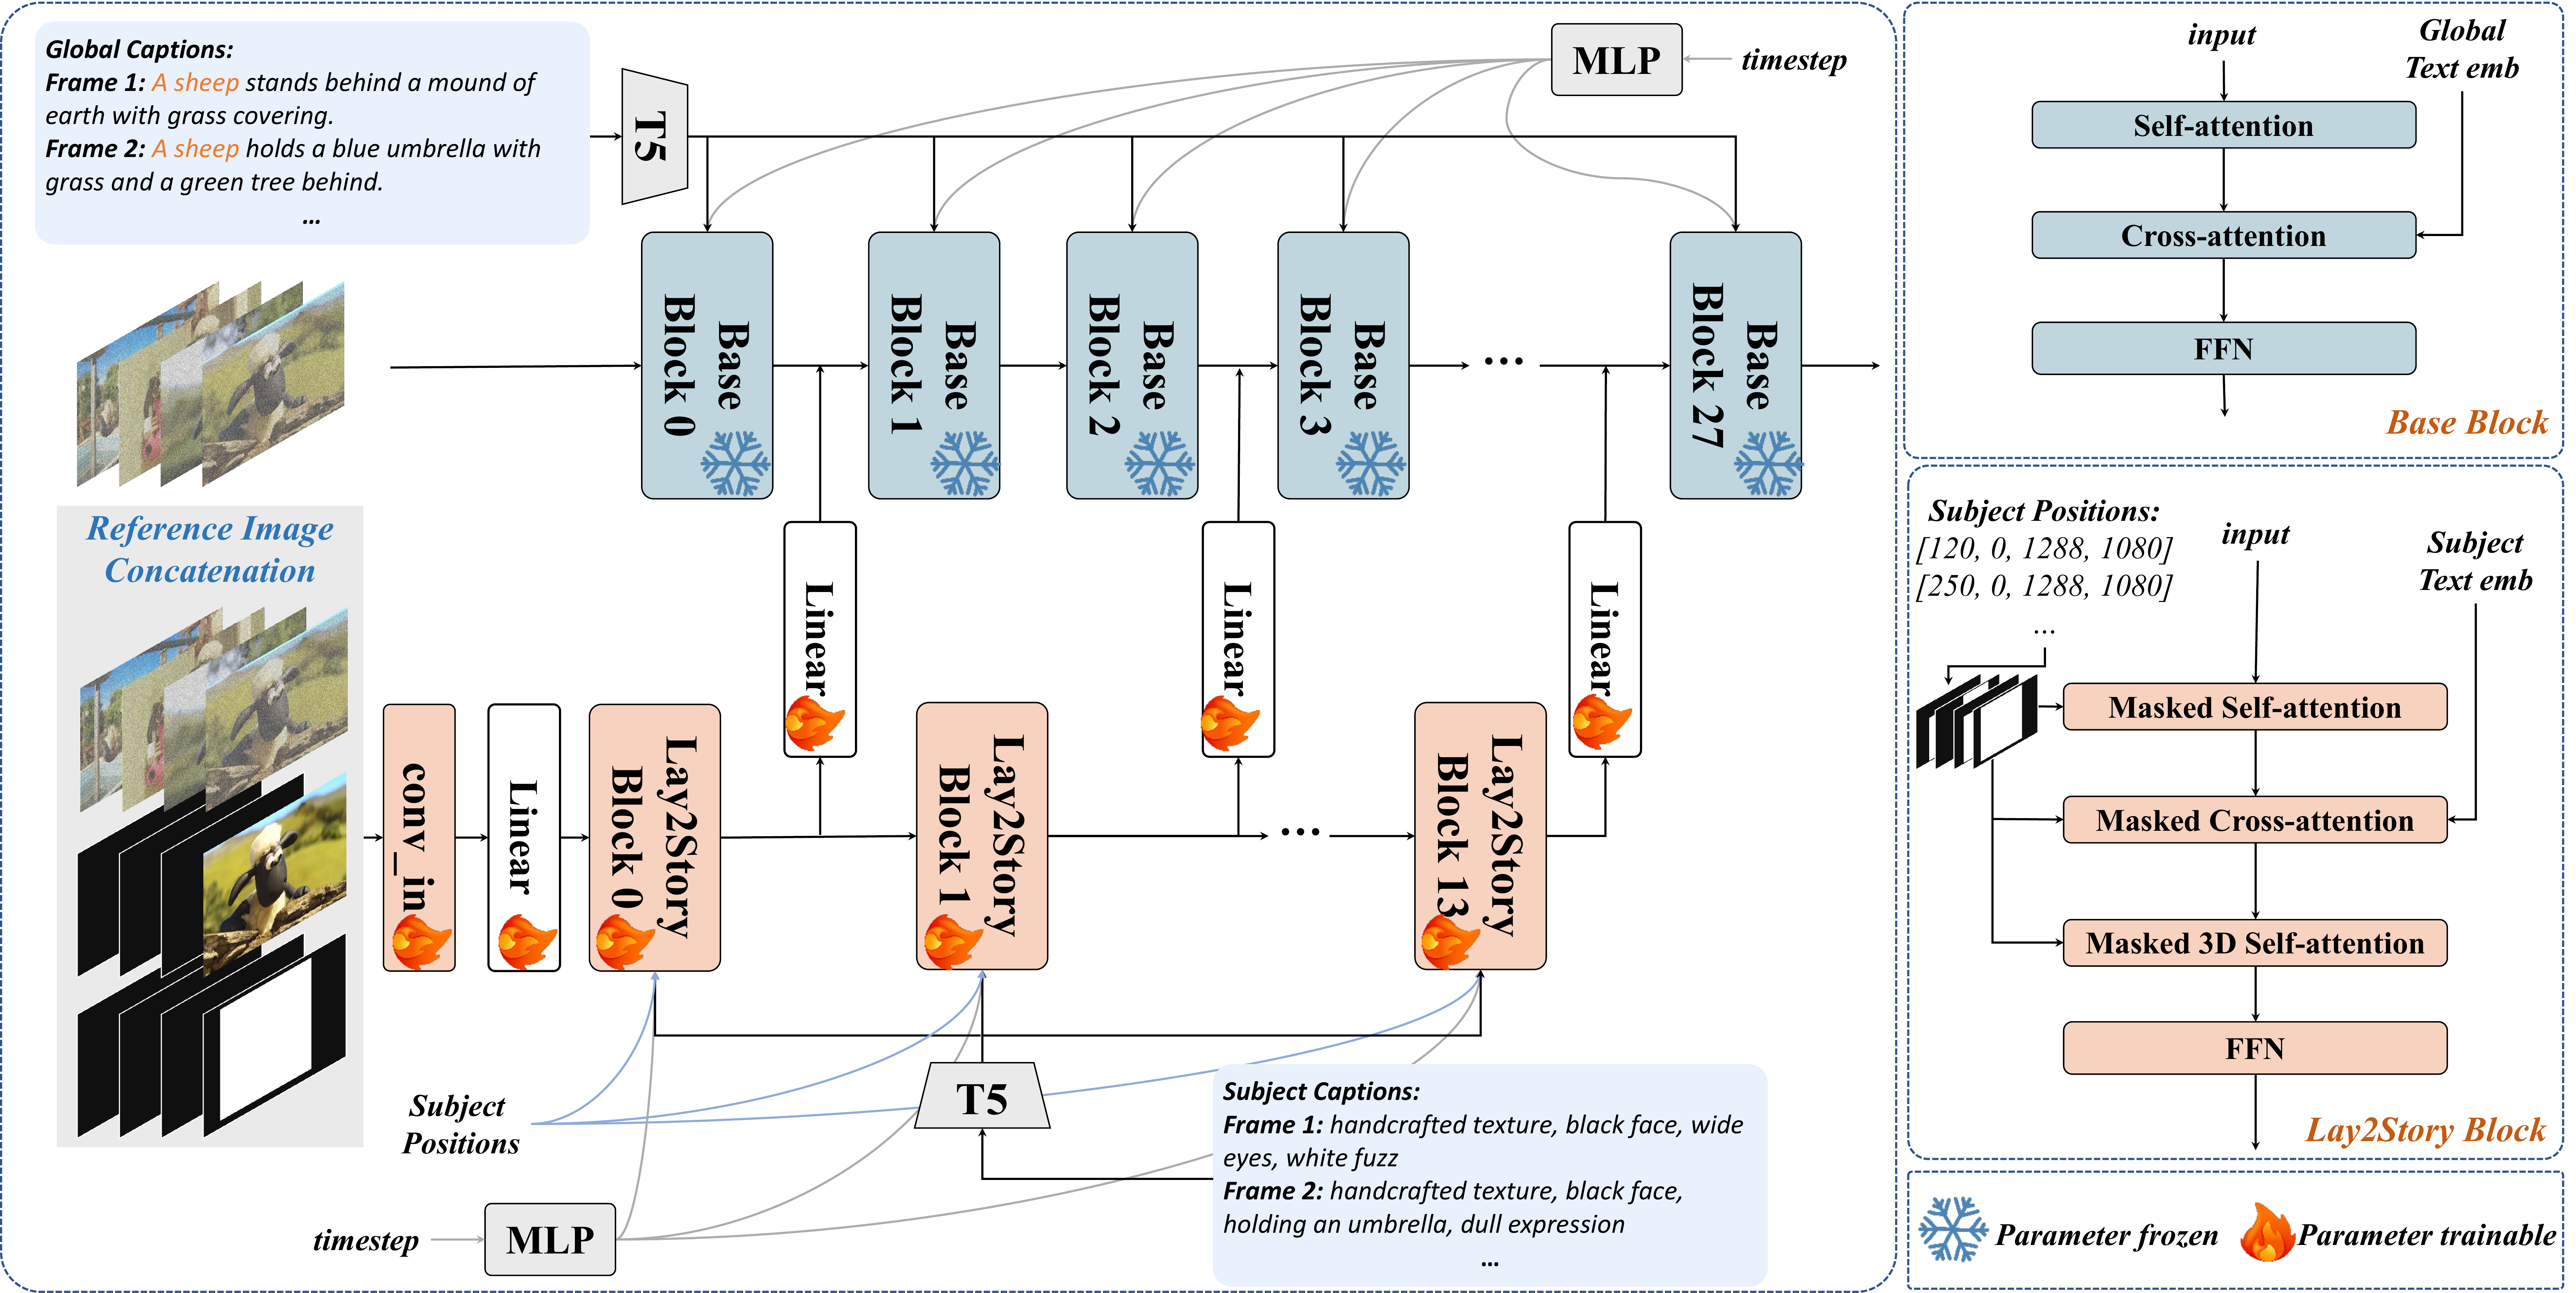
Lay2Story — Extending Diffusion Transformers for Layout-Togglable Story Generation
Storytelling:用一组 prompt 生成多帧图,主角外观要一致。现有 training-free(改 cross-frame attention)和 training-based 都难精细控制位置、衣着、表情、姿势,且缺大规模带 layout 标注的数据。
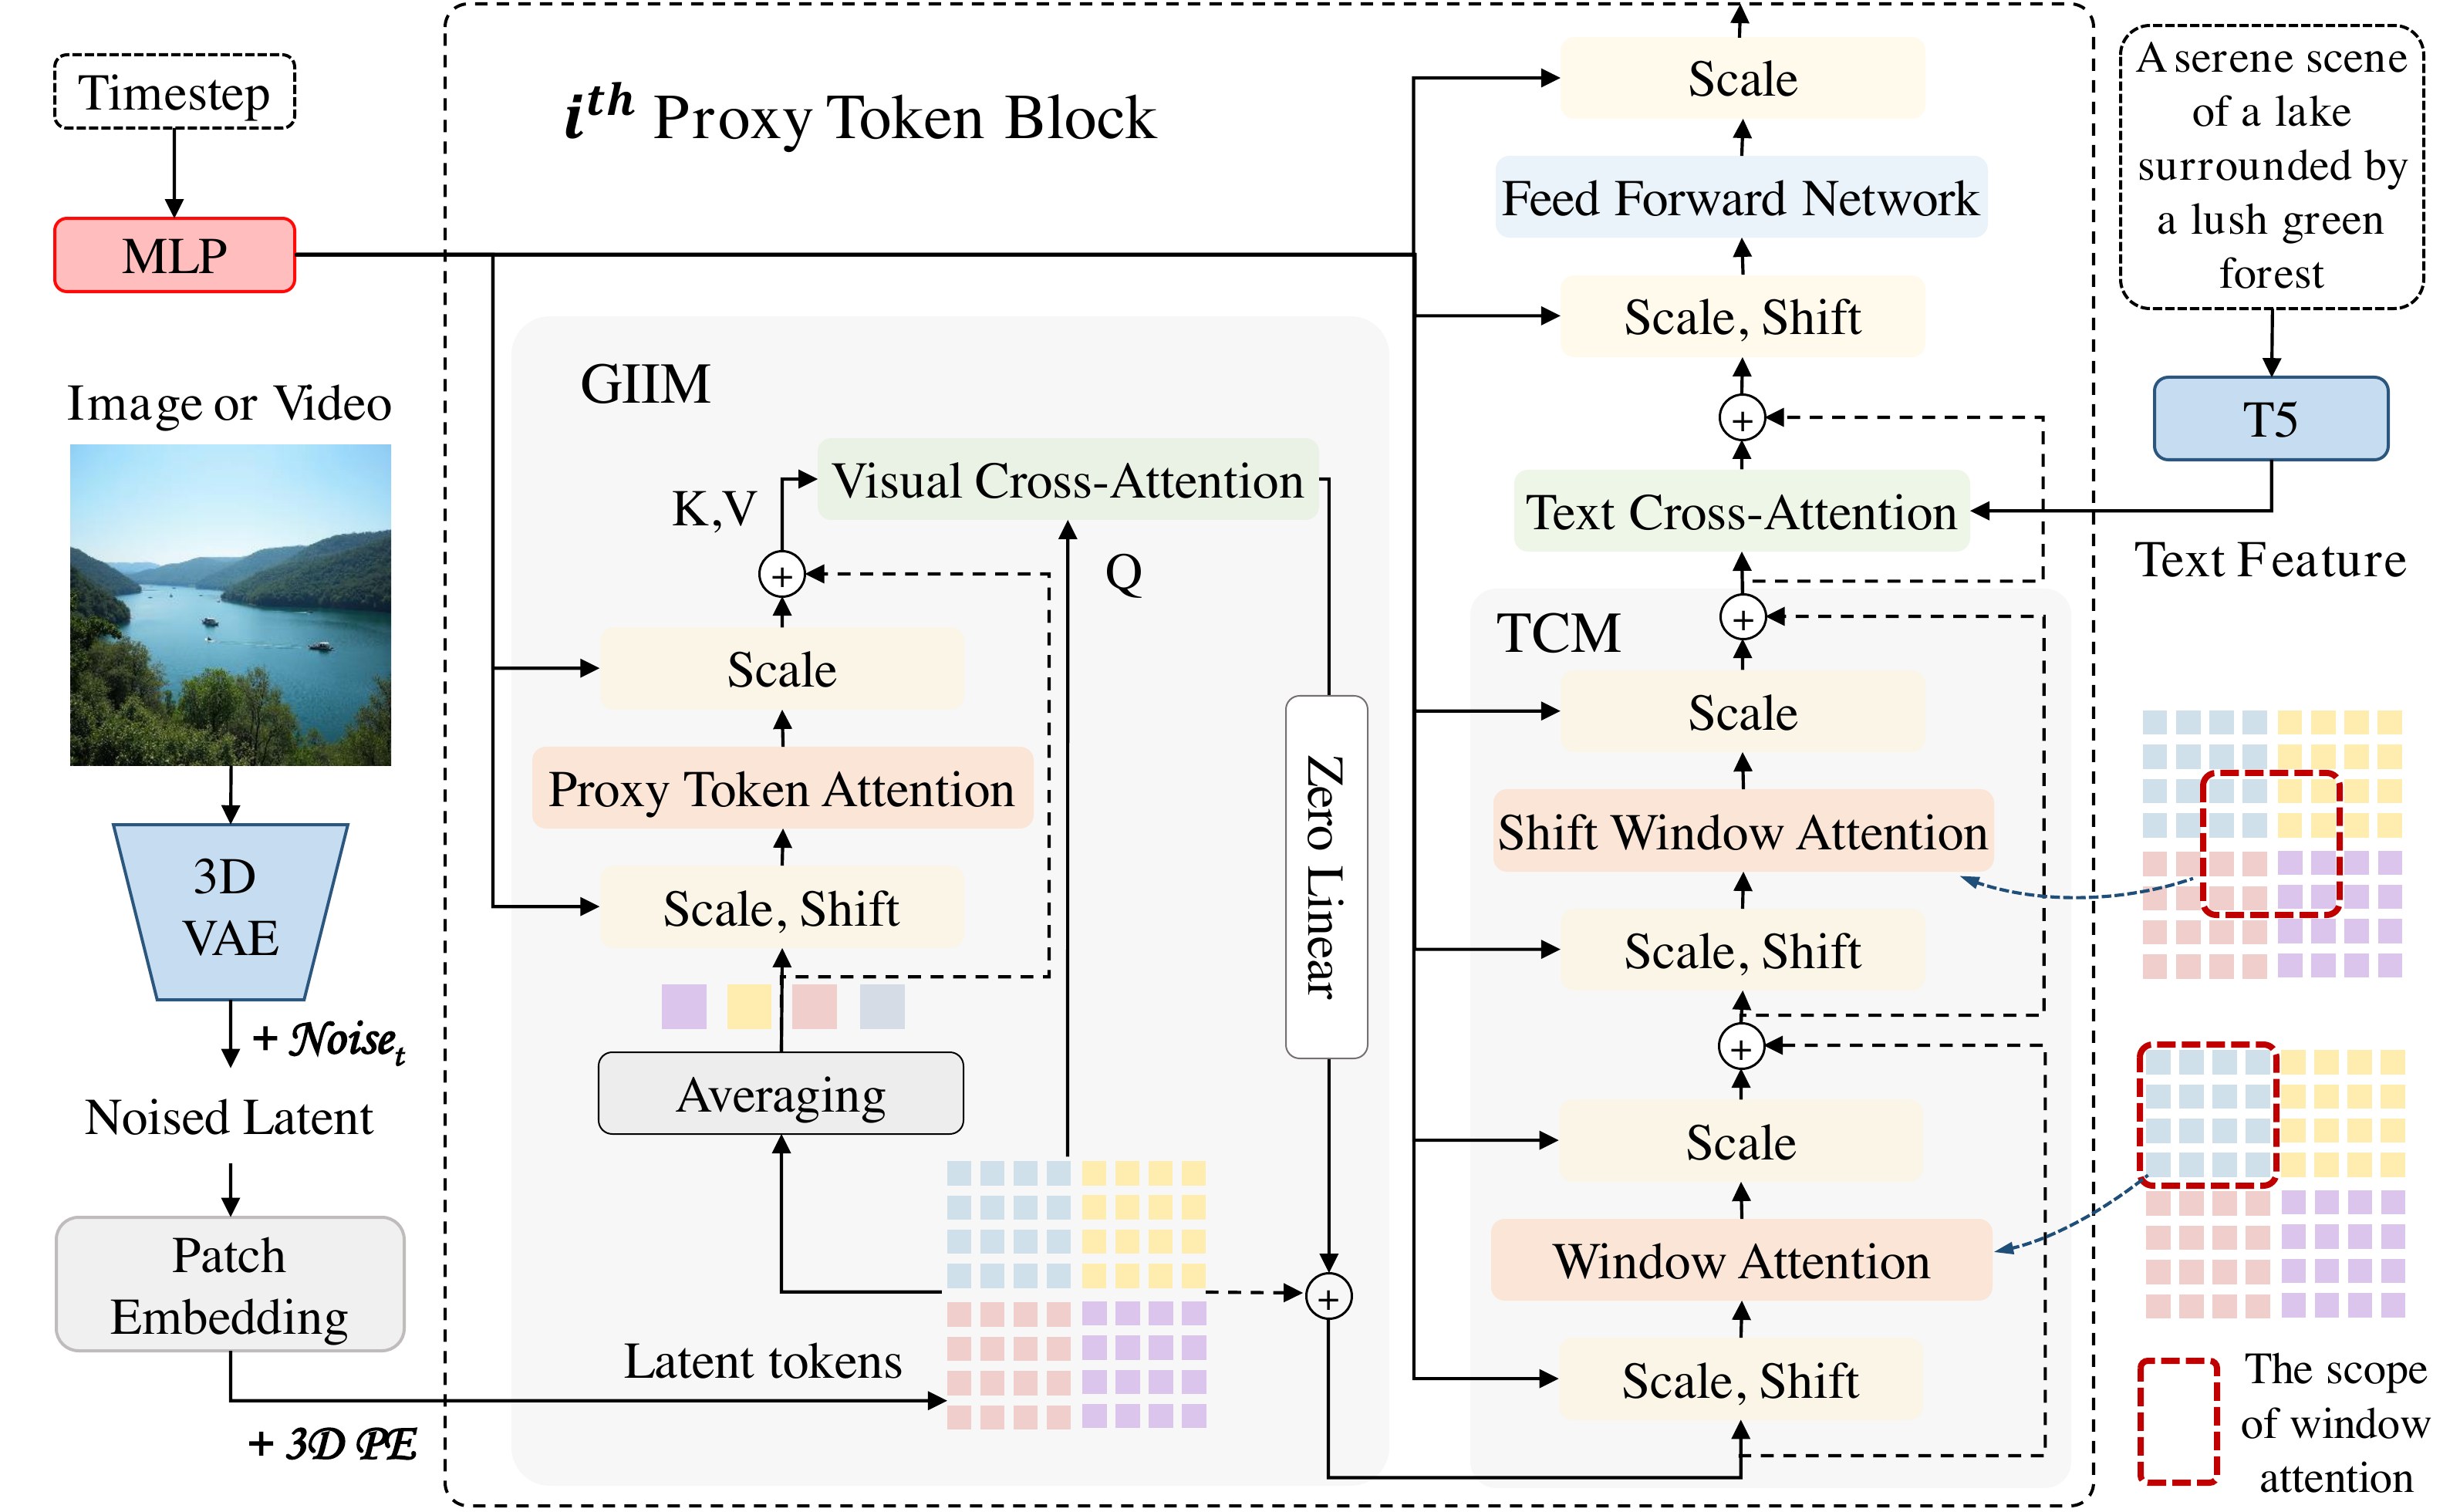
Qihoo-T2X — An Efficient Proxy-Tokenized Diffusion Transformer for Text-to-Any-Task
问题:DiT 全局 self-attention 对视觉 token 是 $O(N^2)$,高分辨率图/长视频算不动;且 PixArt 注意力图显示同窗口内 token 对远处位置注意力几乎一样——大量全局注意力是冗余的。
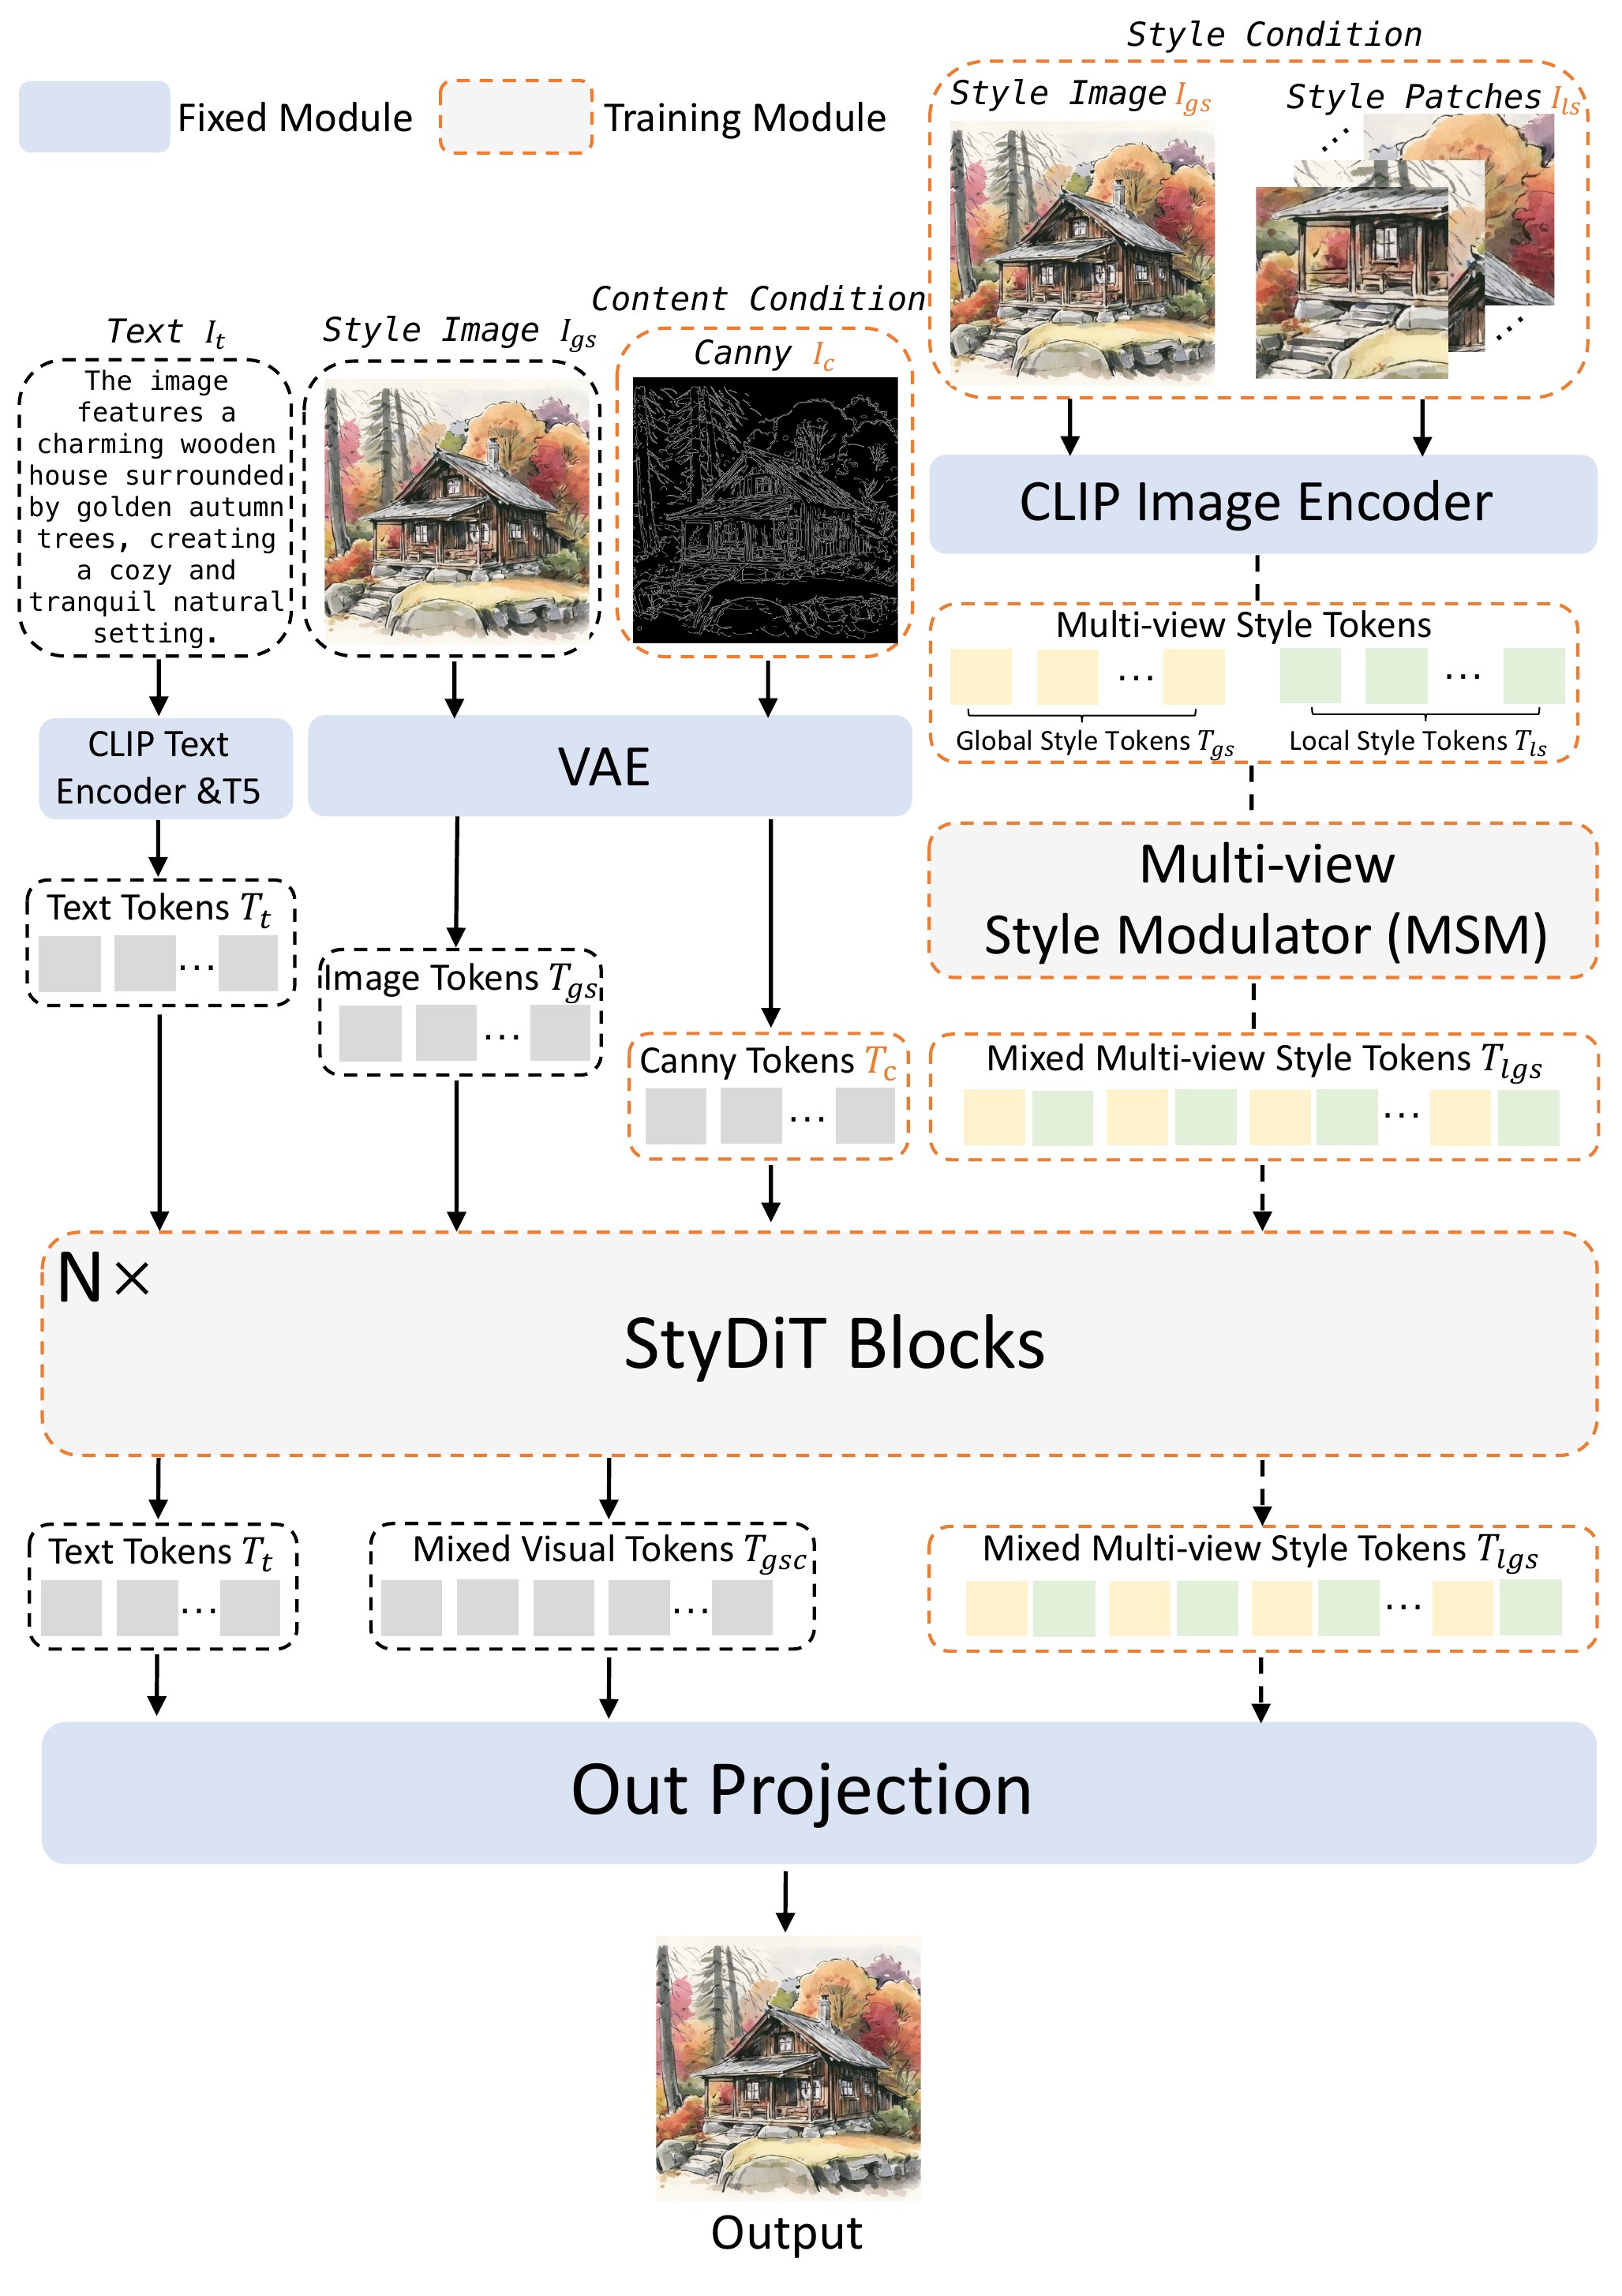
U-StyDiT — Ultra-high Quality Artistic Style Transfer Using Diffusion Transformers
任务:给定内容图 + 风格图,生成超高画质艺术风格化结果——结构跟内容、笔触跟风格,且无伪影/不和谐纹理。
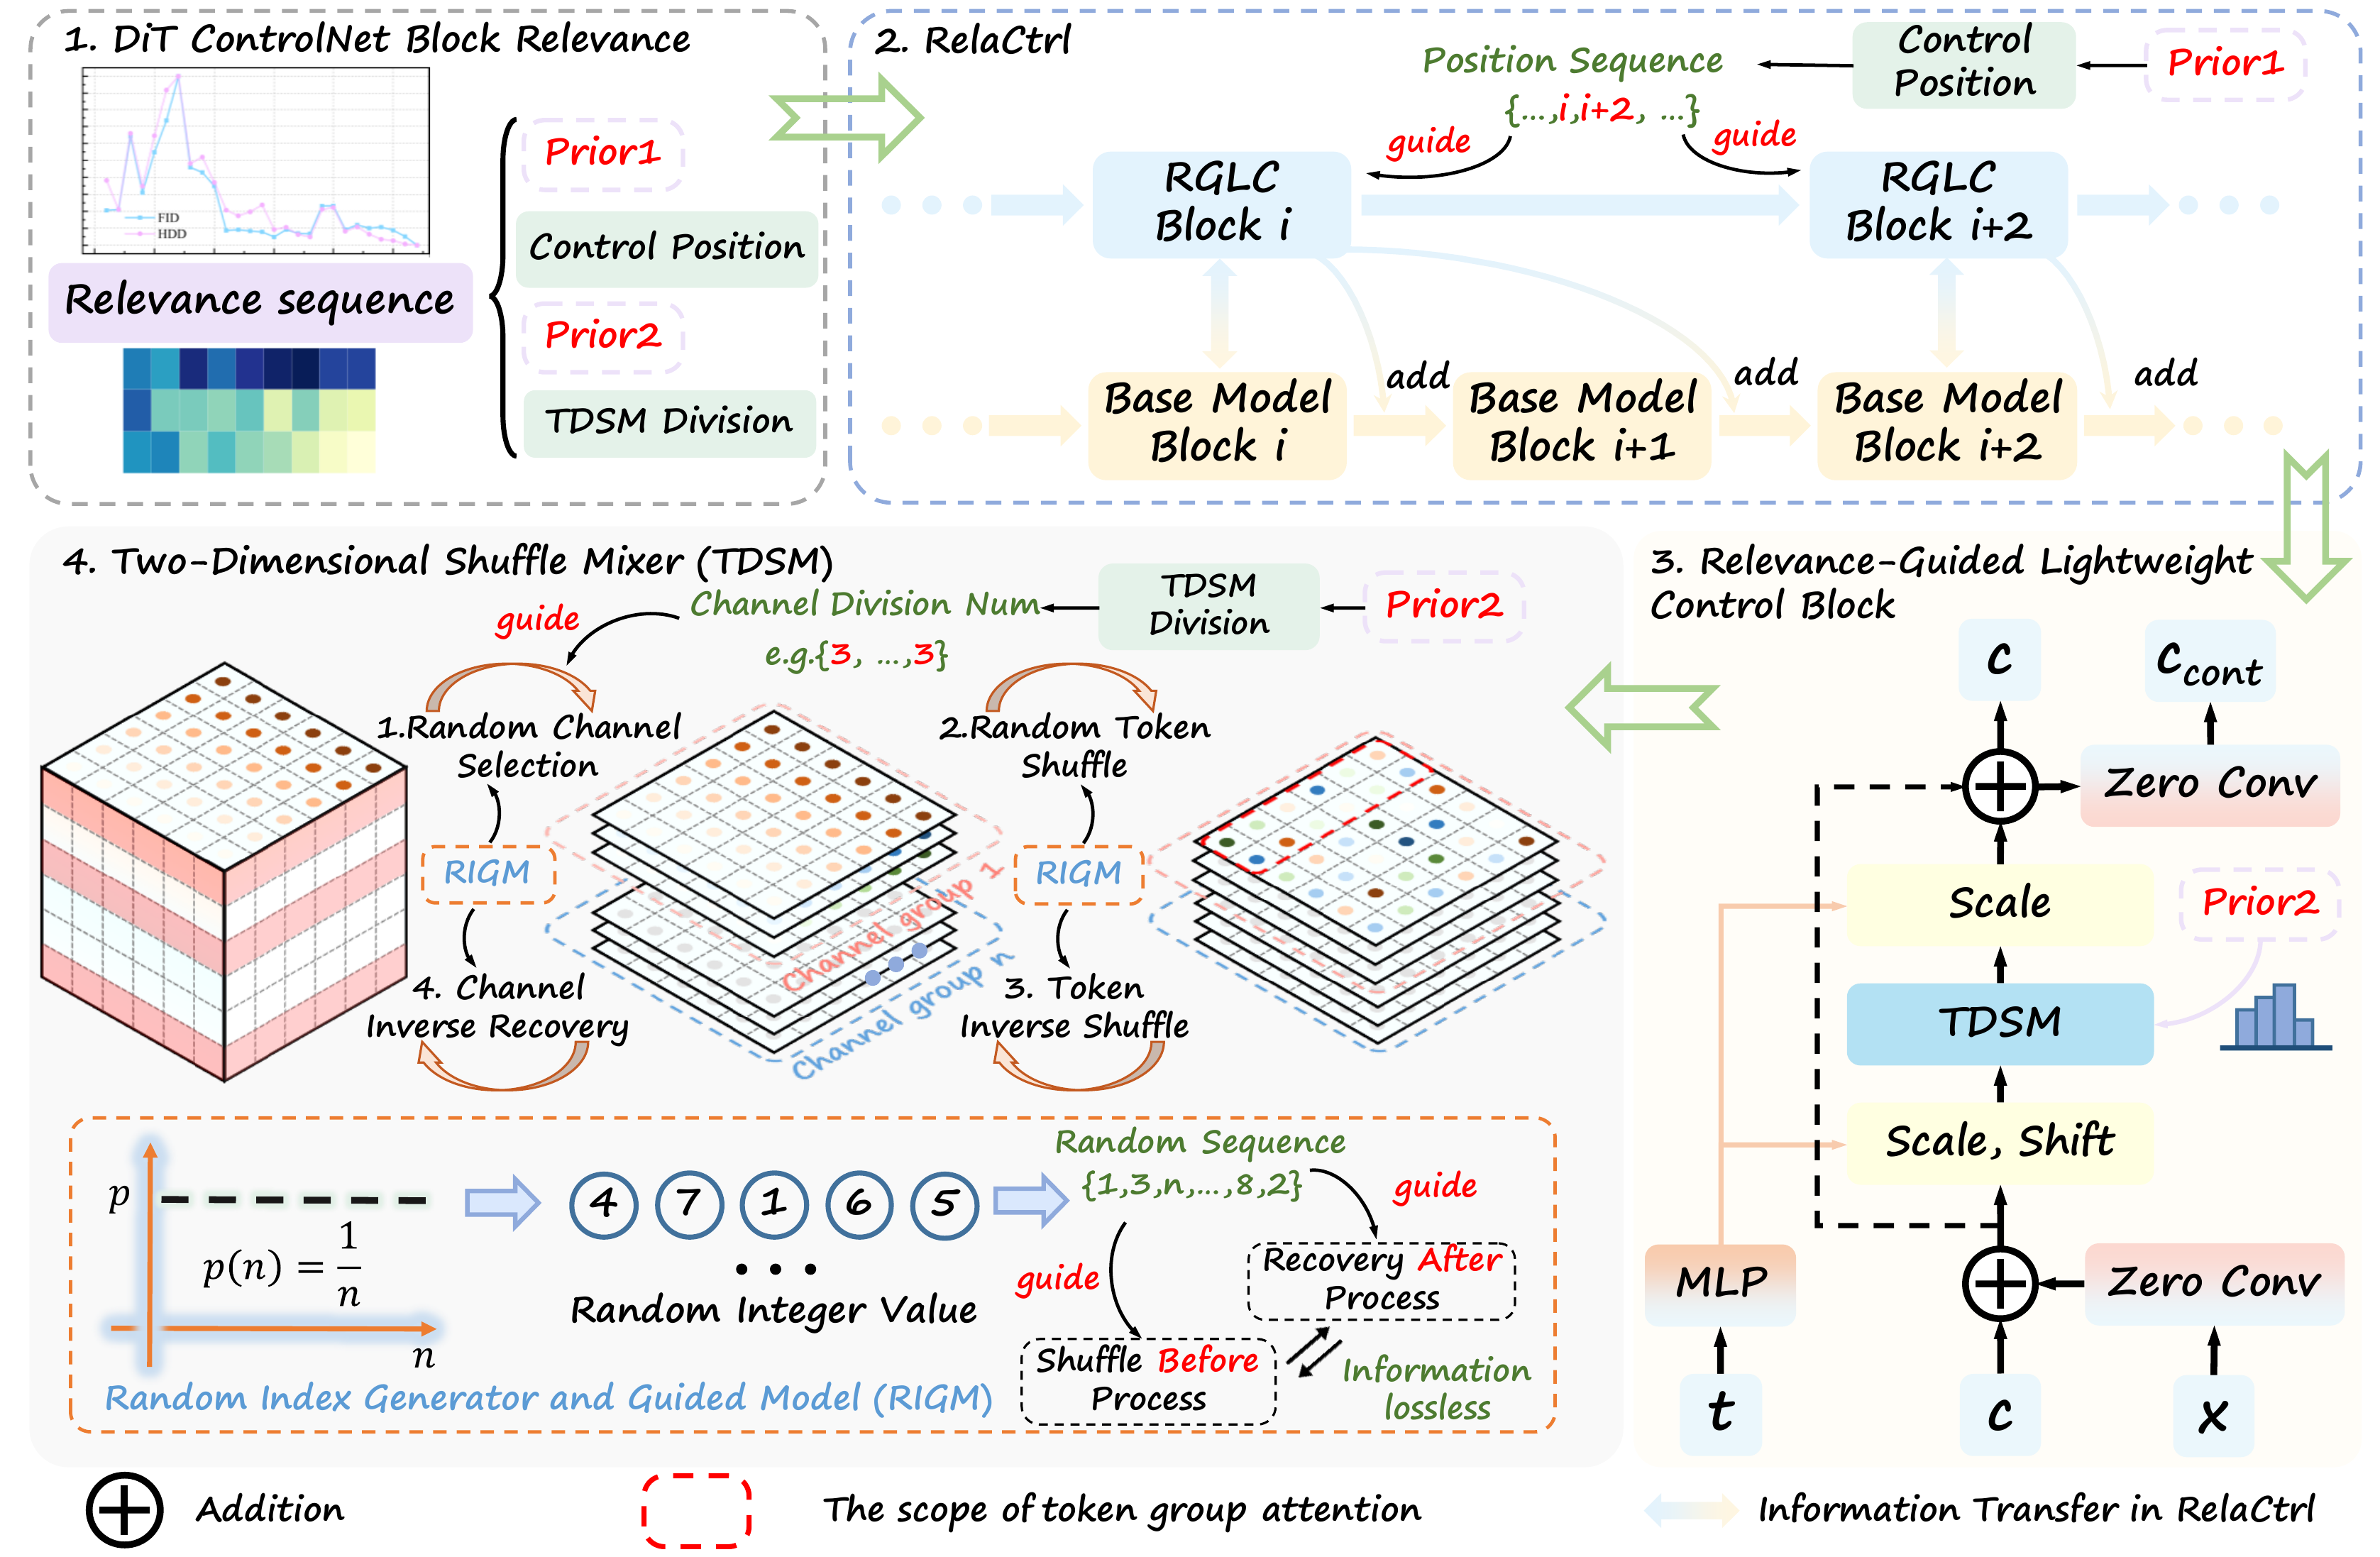
RelaCtrl — Relevance-Guided Efficient Control for Diffusion Transformers
给 DiT 加「可控生成」(Canny、Depth、Seg 等)时,主流做法很「笨重」:PixArt-δ 直接复制前 13 个 DiT block 做 ControlNet,参数和 FLOPs 各涨约 50%;OminiControl 把控制 token 拼进序列,token 数翻倍,FLOPs 涨约 70%。更关键的是——它们假设每一层对控制信号同等重要,均匀堆控制模块,造成大量冗余。
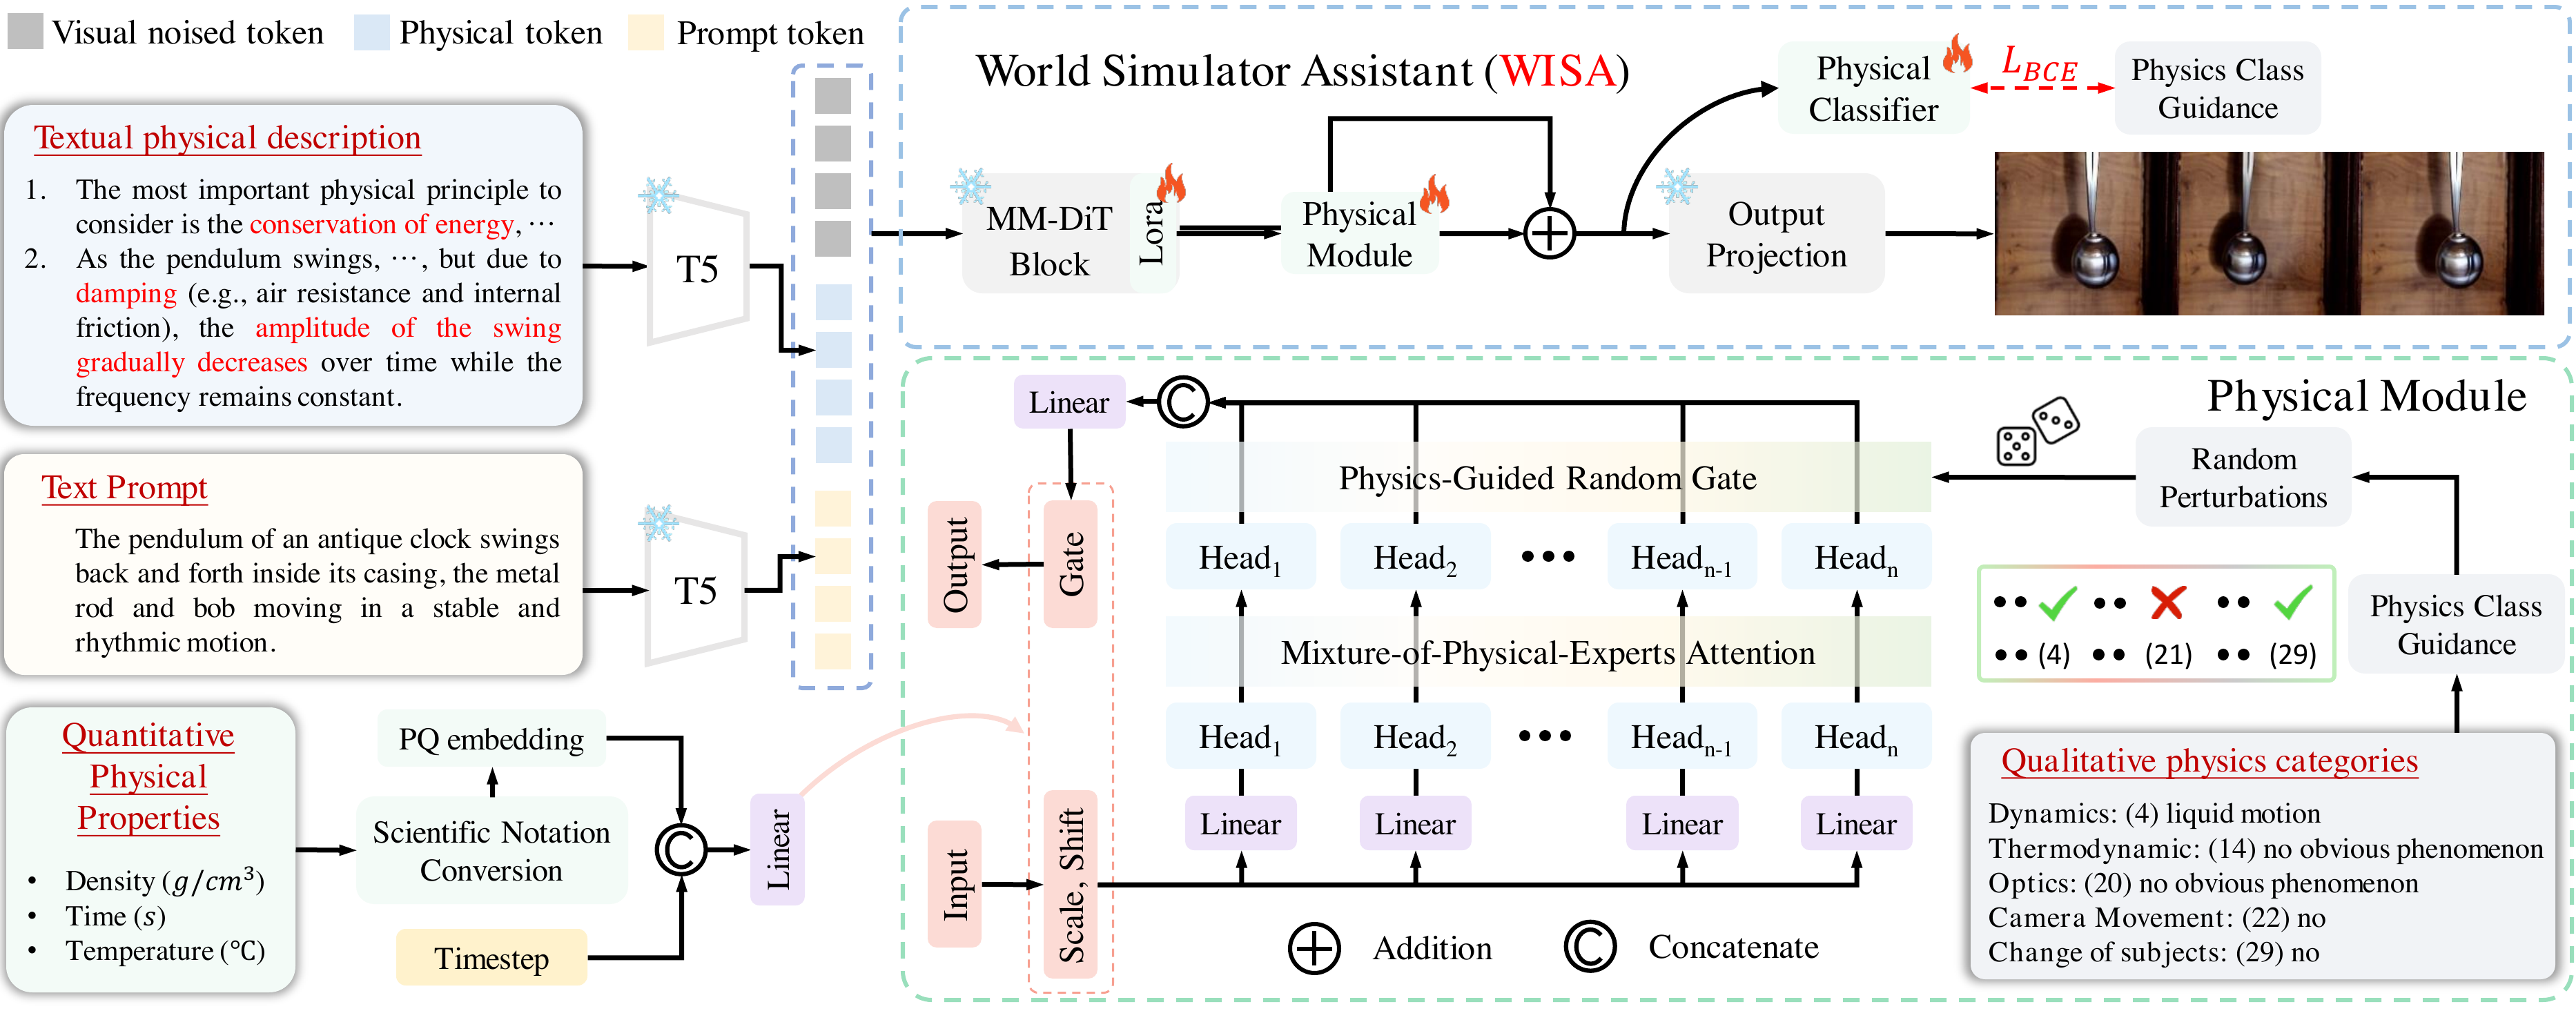
WISA — World Simulator Assistant for Physics-Aware Text-to-Video Generation
Sora、Kling、CogVideoX 能生成逼真视频,但常违反物理:橡皮擦越擦字越黑、苹果落水没有溅起水花、液体运动像随机噪声。根因是抽象物理定律与像素生成之间缺桥梁——模型只学「画面像什么」,没学「过程该怎么演化」。
Recent
Recent