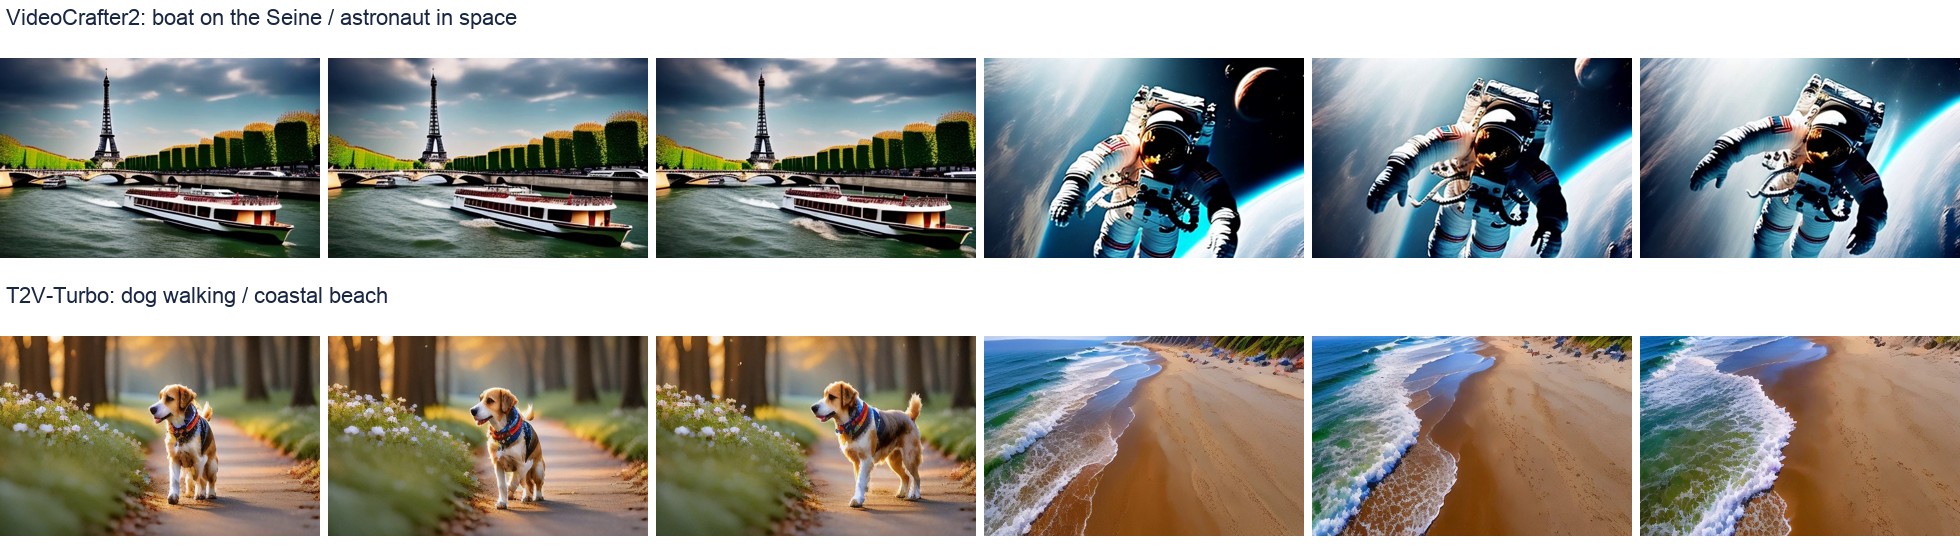
VideoDPO — Omni-Preference Alignment for Video Diffusion Generation
把视频生成模型当成学生:给同一道题(提示词),让它用不同随机种子交四份答案(视频)。自动阅卷系统 OmniScore 同时看画面质量、帧间运动与文本匹配,选出最高分和最低分的视频。训练时不再重新生成整段视频,而是给保存的视频 latent 加噪,让可训练模型和冻结的参考模型分别预测噪声,用“赢家与输家的去噪误差差,相对于参考模型改善了多少”构建偏好损失。
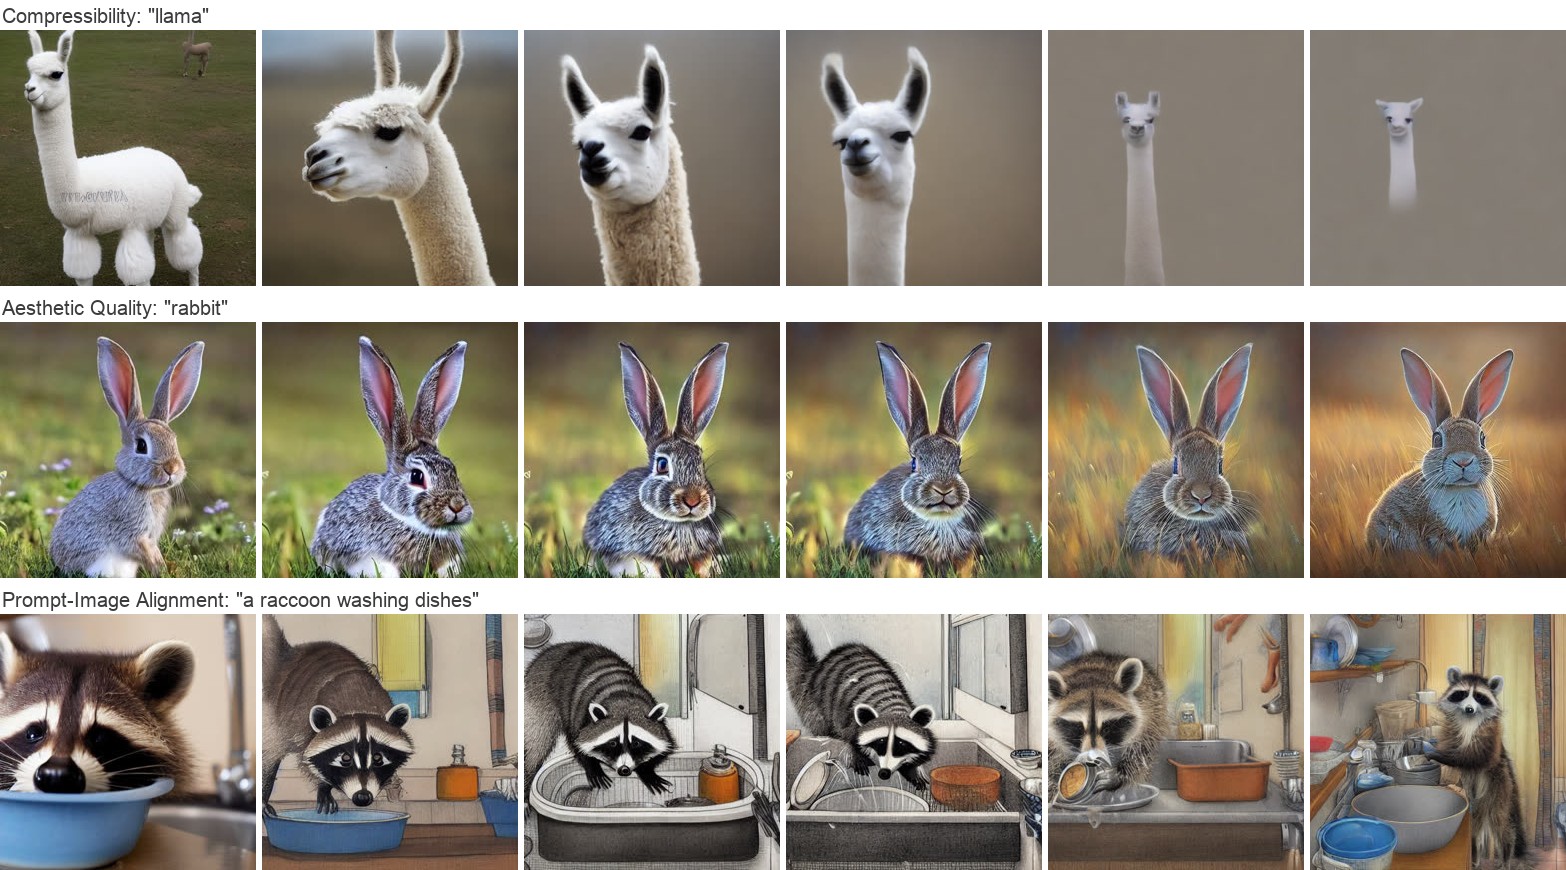
DDPO — Training Diffusion Models with Reinforcement Learning
扩散模型是用「对数似然的近似」训出来的,但我们真正想要的往往不是似然,而是「图好不好看」「文件能不能压小」这类下游指标。这些指标没法写进 prompt,也没法用监督学习直接训。DDPO 的做法是:把 50 步去噪过程当成 50 步决策——每一步的「状态」是(prompt、当前时间步、当前噪声图),「动作」是这一步输出的更干净的图,「策略」就是去噪网络本身。因为采样器固定、每步加的高斯噪声方差已知,每一步的条件似然是可以精确算出来的,于是可以直接套用策略梯度(REINFORCE / PPO):采样一批轨迹 → 给最终图打一个奖励分 → 把奖励乘到「每步 log 概率的梯度」上,好图加分、差图减分…
Recent
Recent