Overview

There are the overall of paper with code for CV / AIGC / LLM / VLM.
https://github.com/Gojay001/paper-with-code-skills.
[Updating…]
VideoDPO — Omni-Preference Alignment for Video Diffusion Generation

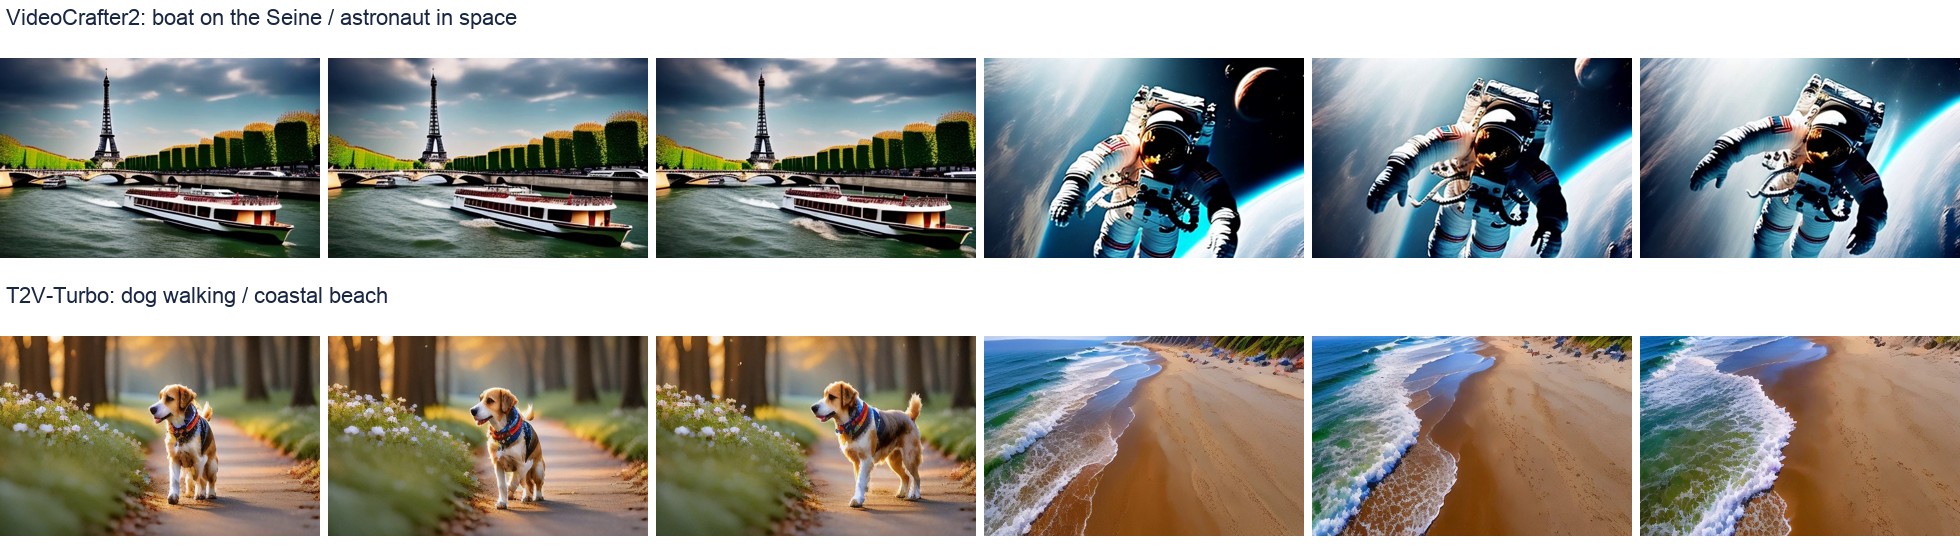
把视频生成模型当成学生:给同一道题(提示词),让它用不同随机种子交四份答案(视频)。自动阅卷系统 OmniScore 同时看画面质量、帧间运动与文本匹配,选出最高分和最低分的视频。训练时不再重新生成整段视频,而是给保存的视频 latent 加噪,让可训练模型和冻结的参考模型分别预测噪声,用“赢家与输家的去噪误差差,相对于参考模型改善了多少”构建偏好损失。

DDPO — Training Diffusion Models with Reinforcement Learning

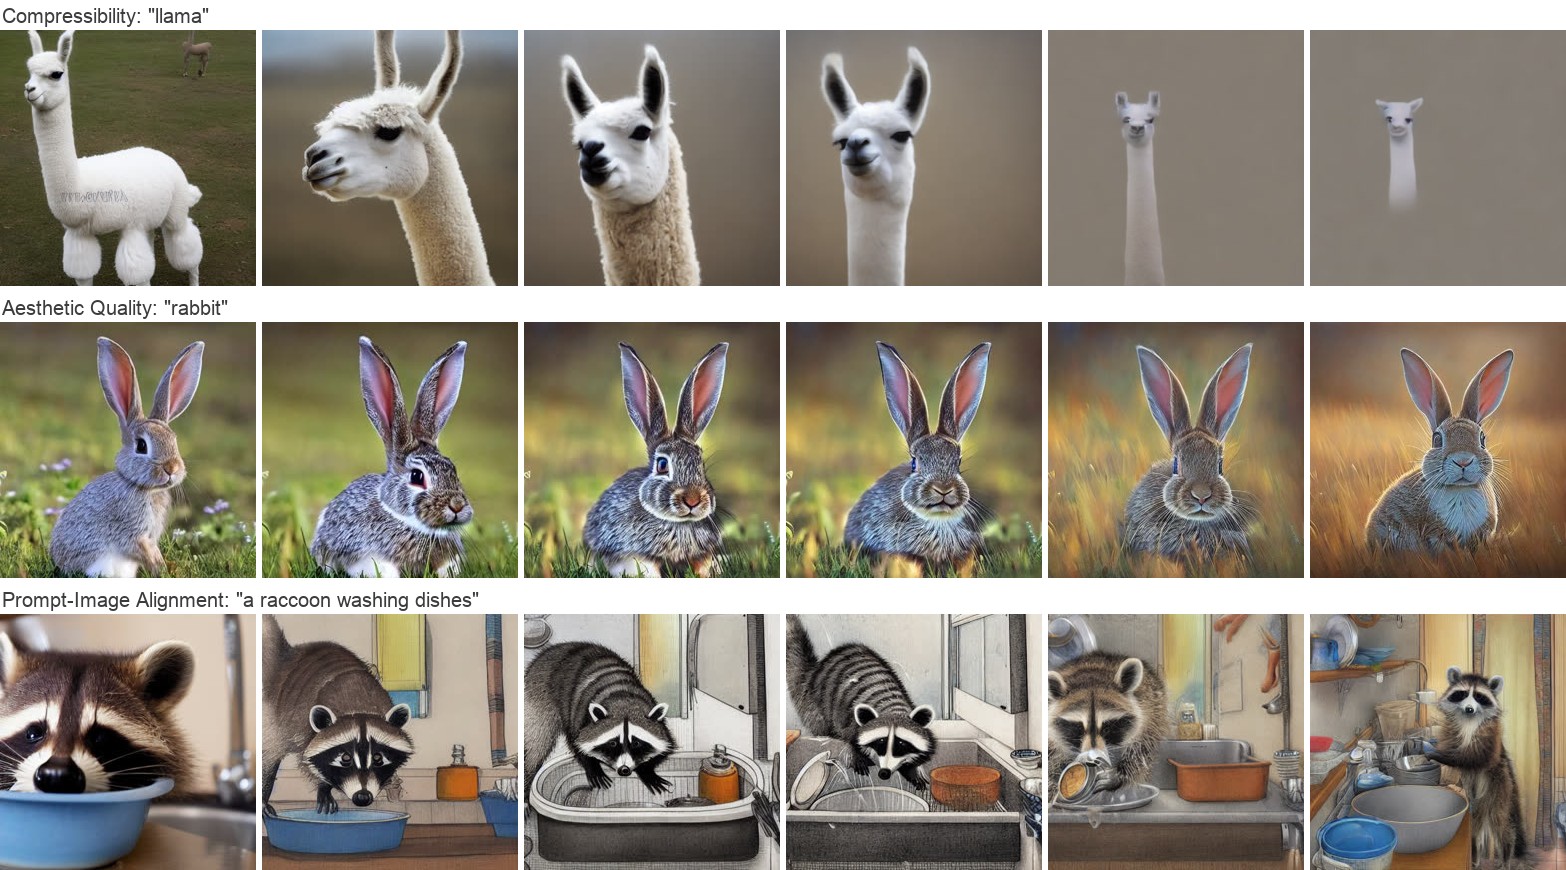
扩散模型是用「对数似然的近似」训出来的,但我们真正想要的往往不是似然,而是「图好不好看」「文件能不能压小」这类下游指标。这些指标没法写进 prompt,也没法用监督学习直接训。DDPO 的做法是:把 50 步去噪过程当成 50 步决策——每一步的「状态」是(prompt、当前时间步、当前噪声图),「动作」是这一步输出的更干净的图,「策略」就是去噪网络本身。因为采样器固定、每步加的高斯噪声方差已知,每一步的条件似然是可以精确算出来的,于是可以直接套用策略梯度(REINFORCE / PPO):采样一批轨迹 → 给最终图打一个奖励分 → 把奖励乘到「每步 log 概率的梯度」上,好图加分、差图减分…

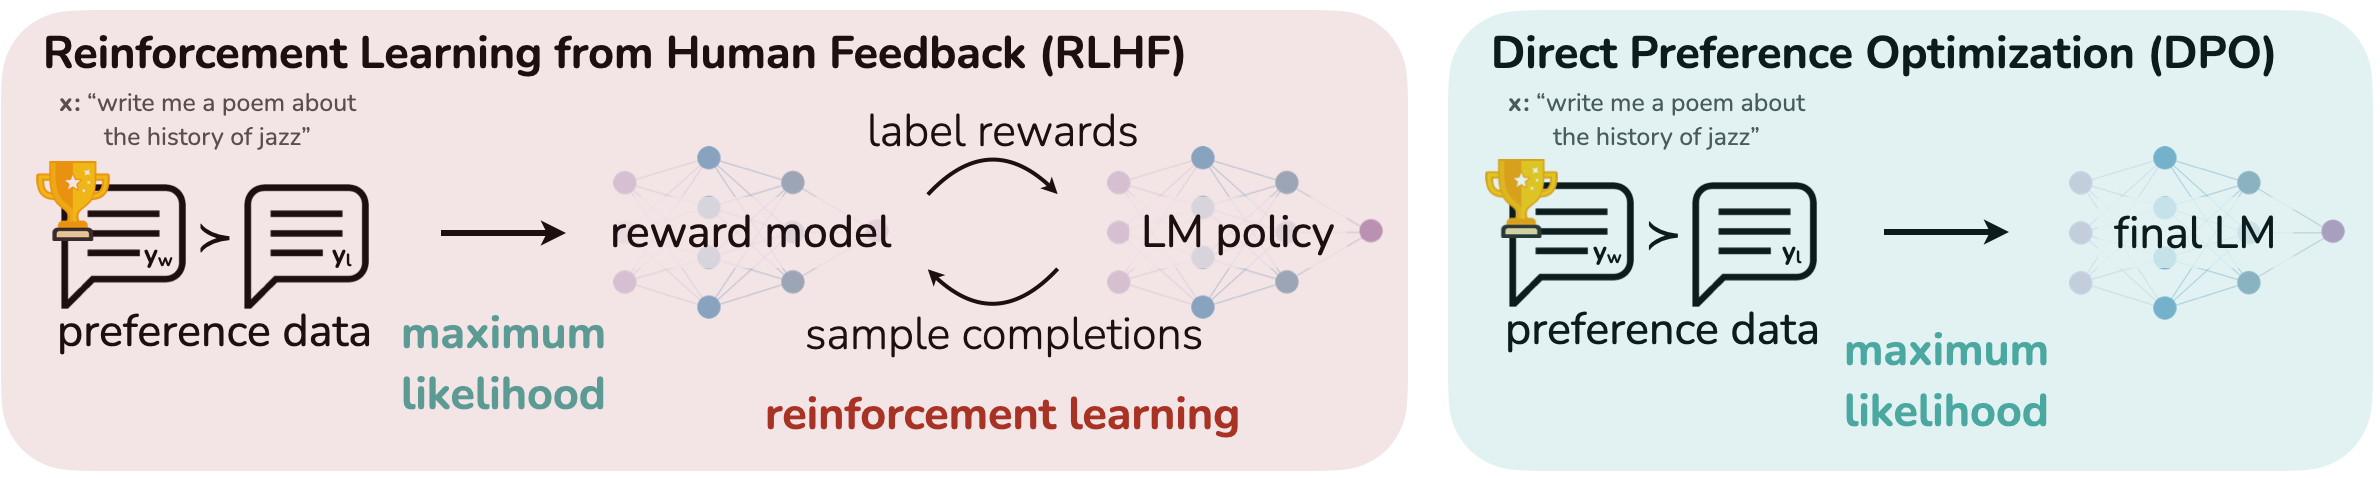
DPO — Direct Preference Optimization: Your Language Model is Secretly a Reward Model

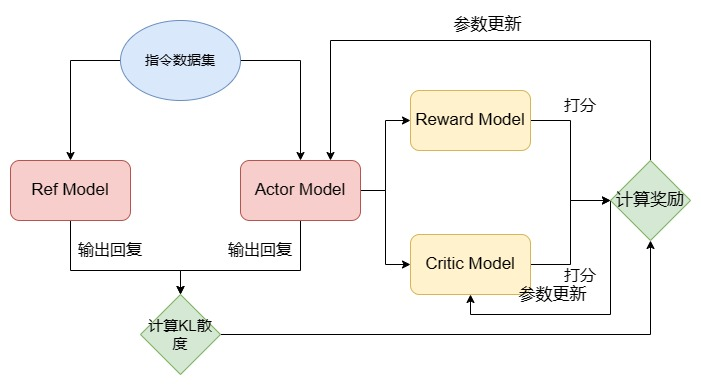
RLHF 要先训一个奖励模型,再用 PPO 在「奖励」上做强化学习——两步、两个模型、还要在训练中反复采样,既贵又不稳。DPO 发现:在 KL 约束下最大化奖励的最优策略有闭式解 $\pi_r \propto \pi_{\text{ref}}\exp(r/\beta)$,把它反解出来就得到 $r=\beta\log(\pi/\pi_{\text{ref}})+\beta\log Z$。奖励只以「差」的形式出现在 Bradley-Terry 模型里,$Z$ 正好抵消——于是「训练奖励模型 + RL」被一个二分类交叉熵损失取代:让「好回答相对差回答的对数概率比」尽量大。梯度还会自动给「判错的样本」…

InstructGPT — Training language models to follow instructions with human feedback

Paper reading notes for InstructGPT — Training language models to follow instructions with human feedback.

MiniMax-H3 — A General-Purpose Omni-Modal Video Generation Model

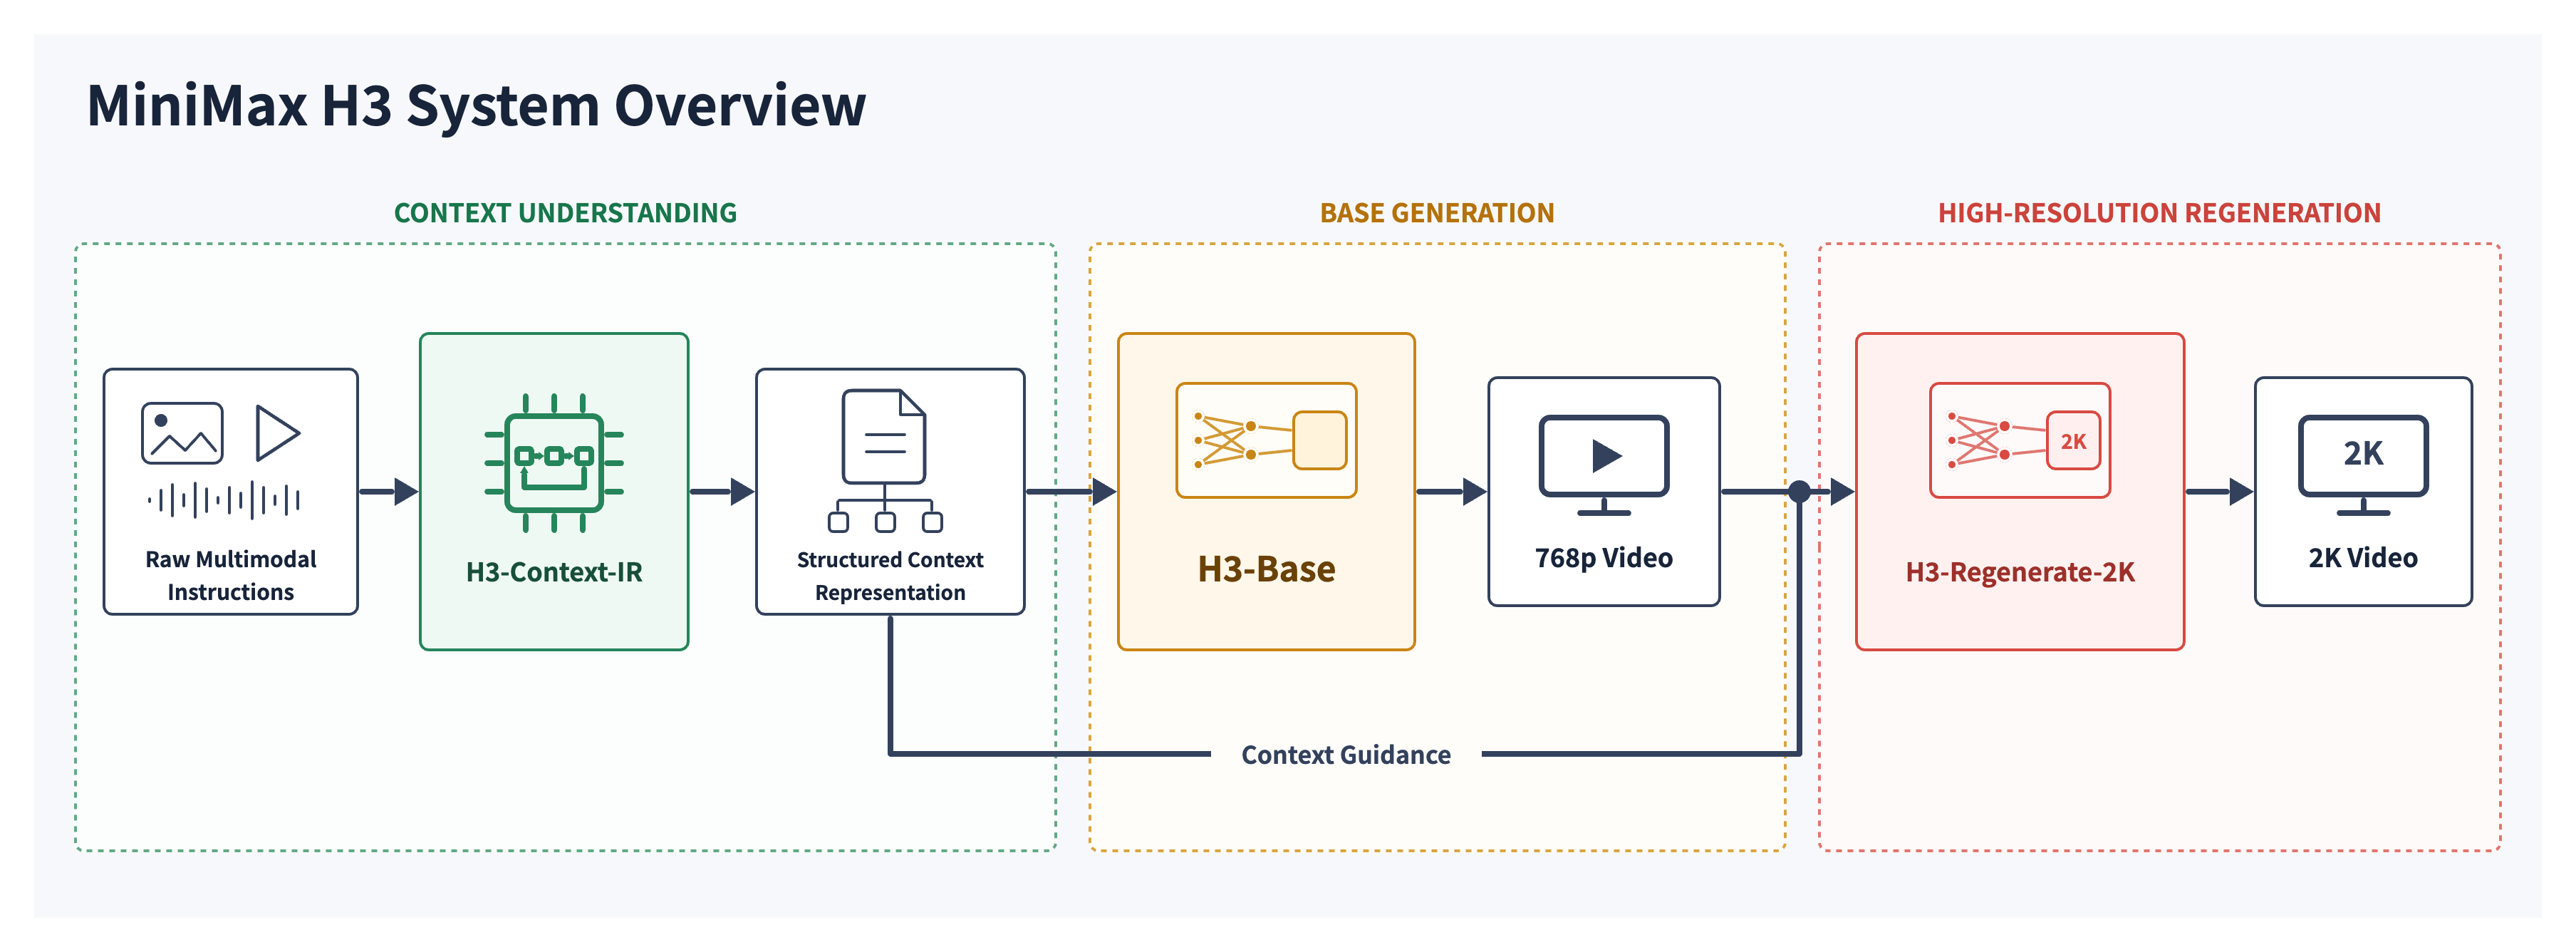
把 MiniMax-H3 想象成一个「全能导演」:你随手丢给它文字、几张图、几段参考视频和几段音频,它先派一个「编剧助理」(H3-Context-IR)把这堆杂乱素材读懂、理顺时序与关系,写成一份结构化的分镜脚本(Context 中间表示);然后「导演本体」(H3-Base,330 亿参数的单流 Transformer)照着脚本一次性把画面和立体声一起拍出来——注意是画面和声音联合生成,而不是先出画面再配音;最后如果你要更高清,它不另请「放大专家」,而是把 768p 成片连同原始素材塞回自己脑子里重画一遍成 2K(H3-Regenerate-2K)。

Your browser is out-of-date!

Update your browser to view this website correctly. Update my browser now

×